8057272 | Подлинная бесплатная доставка из царапины Hadoop Analysis Analysis Версия видео -обучения Wen Chunshui bi jiexin Hadoop Базовые знания Большие данные облачные вычисления Linux System Spark Distributed
Цена: 1 184руб. (¥56)
Артикул: 588632492199
Вес товара: ~0.7 кг. Указан усредненный вес, который может отличаться от фактического. Не включен в цену, оплачивается при получении.
Описание товараПродавец:北京华章图书旗舰店
Адрес:Пекин
Рейтинг:
Всего отзывов:0
Положительных:0
Добавить в корзину
Другие товары этого продавца


¥ 30 18.99402руб.
¥46.9991руб.
¥18.7396руб.
¥49.71 051руб.

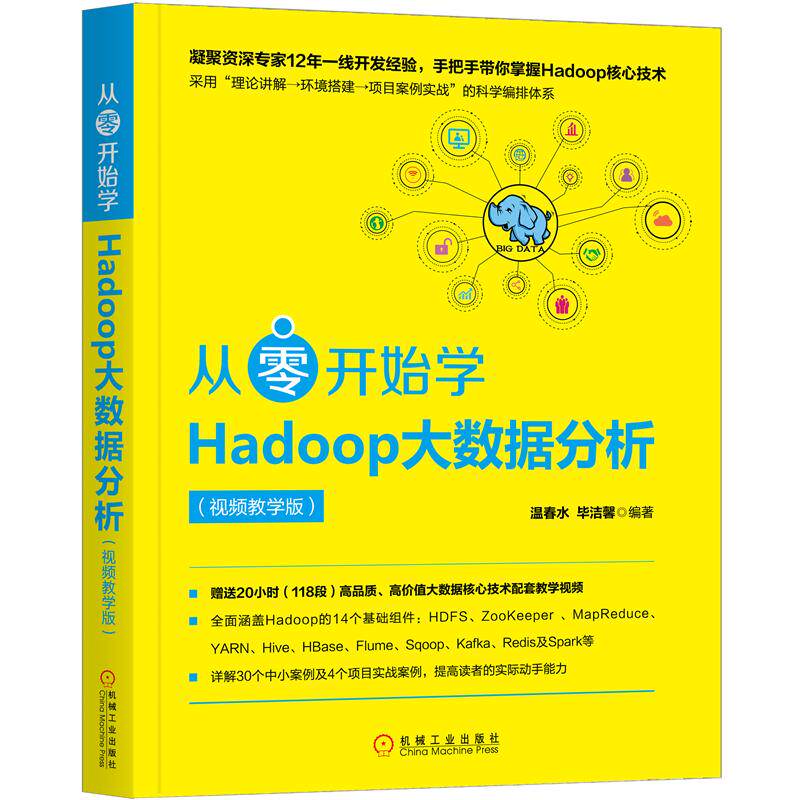
Сбор старших экспертов за 12 лет опыта развития с фронтом, взять вас за руку, чтобы освоить основную технологию Hadoop, усыновить“Теоретическое объяснение———&Rdquo;
Информация о товаре предоставляется издателем, которая может немного отличаться от опубликованных товаров. Продукты подлежат реальным товарам.
 |
 |
| |

|   Книга   имя: |   |
|   Цена книги: |   89 Юань |
|   автор: | |
| out   Общество: |   Machinery Industry Press |
|   Дата публикации: | 2019-03-04 |
| ISBN номер: | 9787111619314 |
|   открыто   Книга: | 16 |
|   страница Количество: | 368 |
|     раз: | 1-1 |
 |
| Эта книга предназначена для начинающих, которые готовы присоединиться к индустрии больших данных, и представила основные технологии и связанные с ним случаи процедур больших данных на простых и забавных языках.Содержание включает в себя базовую концепцию данных, установку и конфигурацию HADOOP, HDFS, HDFS HDFS Высокая доступность, Zookeeper, MapReduce, пряжа, SQOOP, KAFKA, REDIS, и каждая точка знаний оснащена случаями Чтобы понять процесс строительства и разработки корпоративных случаев от построения среды больших данных до основной технологии больших данных, чтобы легко ввести поле больших данных.Эта книга сильно практична, которая очень подходит для чтения читателей больших данных Hadoop, а также подходит для соответствующих колледжей в качестве учебников для анализа больших данных и добычи. |
 |
Предисловие Глава 1 базовые знания Hadoop ГЛАВА 1 ЗНАЙТЕ HADOOP 2 1.1 Предварительное исследование больших данных 2 1.1.1 Технология больших данных 2 1.1.2 Структура технологии больших данных 3 1.1.3 Особенности больших данных 3 3 1.1.4 Применение больших данных в различных отраслях 4 1.1.5 Режим вычисления больших данных 4 1.1.6 Связь между большими данными и облачными вычислениями и Интернетом вещей 4 1.2 Введение в Hadoop 5 1.2.1 Hadoop. Статус -кво 6 1.2.2 Профиль Hadoop и значение 6 1.3 Резюме 6 Глава 2 Установка и конфигурация Hadoop 7 2.1 Создание виртуальной машины 7 2.2 Установите систему Linux 10 2.3 Настройте информацию о сети 11 2.4 Clone Server 12 2.5 SSH -пароль бесплатный вход в систему 13 2.6 Установка и конфигурация JDK 15 2.6.1 Загрузить пакет установки 15 2.6.2 Установить JDK 16 2.6.3 Переменная среда конфигурации 16 2.7 Конфигурация переменной среды Hadoop 16 2.7.1 Унзифоп сжатый пакет 17 2.7.2 Настройте папки Hadoop's Bin и SBIN на 17 в переменных окружающей среды 17 2.7.3 Modify /etc/hadoop/hadoop-env.sh 17 2.8 Hadoop Распределенная установка 17 2.8.1 Псевдо -распределительная установка 17 2.8.2 Полностью распределенная установка 19 2.9 Резюме 21 Глава 3 Hadoop Распределенная файловая система 22 3.1 DFS Введение 22 3.1.1 Что такое DFS 22 3.1.2 Структура DFS 22 3.2 Введение в HDFS 23 3.2.1 Концепция и архитектура HDFS 23 3.2.2 HDFS Design 23 3.2.3 Преимущества и недостатки HDFS 24 3.2.4 Принцип выполнения HDFS 24 3.2.5 Основная концепция HDF 25 3.2.6 HDFS Чтение файлов процесс 27 3.2.7 HDFS Записать процесс 28 3.2.8 Стратегия размещения блока 29 3.3 Общие команды HDF в Hadoop 30 3.3.1 Работа файла 30 3.3.2 Управление и обновление 31 3.4 Применение HDFS 31 3.4.1 Работа на основе Shell 31 3.4.2 Операция на основе Java API 33 3.4.3 Создайте папку 34 3.4.4 Рекурсивный файл отображения 34 3.4.5 Загрузка файла 35 3.4.6 Скачать файл 35 3.5 Сводка 36 Глава 4 HDFS High доступен 37 на основе Hadoop 3 4.1 Hadoop 3.x разработка 37 4.1.1 Hadoop 3 Новые функции 37 4.1.2 Hadoop 3 HDFS Cluster Architecture 38 4.2 Hadoop 3 HDFS Полная распределенная конструкция 39 4.2.1 Установить JDK 40 4.2.2 Настройка переменной среды JDK 40 4.2.3 Настройте пароль бесплатный вход в систему 40 4.2.4 Настройте отношения IP и имени хоста. 4.2.5 SSH пароль бесплатный вход настройки 41 4.2.6 Настройка Hadoop 3.1.0 42 4.3 Что такое HDFS High доступно 47 4.3.1 HDFS Высокий доступный принцип реализации 47 4.3.2 HDFS Высокая доступная реализация 48 4.4 Строительство HDFS Высокая доступность 50 4.4.1 Настройка Zookeeper 50 4.4.2 Файл конфигурации конфигурации 52 4.4.3 Скопируйте файл конфигурации в другие узлы 54 4.4.4 Запустите узел JN 54 4.4.5 Формат 55 4.4.6. Скопируйте метаданные до 55 на узлах Node2 4.4.7 Форматирование ZKFC 55 4.4.8 Start Cluster 56 4.4.9 Просмотреть статус кластера через браузер 56 4.4.10 Высокий доступный тест 57 4.5 Резюме 58 Глава 2 Hadoop Core Technology Глава 5 Распределенная служба Координации Hadoop——ZooKeeper 60 5.1 Основная концепция Zookeeper 60 5.1.1 Механизм сеанса 60 5.1.2 Узел данных, версия и наблюдатель 61 5.1.3 ACL стратегия 61 5.2 Установка и работа Zookeeper 61 5.3 Общие команды на сервере Zookeeper 63 5.4 Связанная операция клиента подключает Zookeeper 64 5.4.1 Просмотреть Zookeeper Обычно используемые команды 64 5.4.2 Команда Connect и команда LS 65 5.4.3 Создать команду—— 5.4.4 Получить команду—— 5.4.5 Установить команду—— 5.4.6 Удалить команду—— 5.5 Используйте Java API для доступа к Zookeeper 67 5.5.1. Подготовка окружающей среды и создание примеров сеанса 68 5.5.2 Пример создания узла 69 5.5.3 Java API Access Zookeeper Encament 70 5.6 Резюме 73 Глава 6 Распределенная рамка расчета в автономном режиме——MapReduce 74 6.1 Обзор MapReduce 74 6.1.1 Характеристики MapReduce 74 6.1.2 Сценарий применения MapReduce 75 6.2 Процесс выполнения MapReduce 76 6.2.1 Статистический пример словарного запаса 76 6.2.2 Процесс выполнения MapReduce 77 6.2.3 MapReduce File Scies Split 77 6.2.4 MAP -процесс и уменьшить процесс 78 6.2.5 Процесс перетасовки 78 6.3 MapReduce Encament 79 6.3.1 Пример локального теста Word Count 79 6.3.2 ETL локальный тест Пример 84 6.4 Пример сортировки температуры 86 6.4.1 Упаковка времени и температуры mykey.java 87 6.4.2 MAP Задача myMapper.java 88 6.4.3 Класс пакетов данных MyGroup.java 89 6.4.4 Сортировка температуры mysort.java 89 6.4.5 Разделение данных MyPartitioner.java 90 6.4.6 Задача REDUCER MYREDUCER.JAVA 90 6.4.7 Основная функция runjob.java 91 6.5 Резюме 94 Глава 7 Система управления ресурсами Hadoop——YARN 95 7.1 Зачем использовать пряжу 95 7.2 Основная архитектура пряжи 96 7.2.1 Processemanager Process 96 7.2.2 ApplicationMaster и Nodemanager 97 7.3 Рабочий процесс пряжи 97 7.4 Строительство пряжи 98 7.5 Сводка 100 Глава 8 Структура хранилища данных Hadoop——Hive 101 8.1 Теоретическая основа уля 101 8.1.1 Что такое улей 101 8.1.2 Сходства и различия между Hive и Database 102 8.1.3 Цель и применение дизайна улей 104 8.1.4 Hive's Running Architecture 104 8.1.5 Процесс выполнения улья 105 8.1.6 Служба уляя 106 8.1.7 Yuan Store Metastore 106 8.1.8 Встроенный режим 107 8.1.9 локальный режим 108 8.1.10 Удаленный режим 109 8.2 Конфигурация и установка Hive 109 8.2.1 Установить MySQL 110 8.2.2 Настройка улья 112 8.3 Работа улей таблицы 113 8.3.1 Создать улей таблица 114 8.3.2 Данные импорта 114 8.4 Таблицы и подразделение и подразделение 115 8.4.1 Раздел Таблицы 115 8.4.2 Таблицы таблиц 117 8.5 Внутренняя таблица и внешняя таблица 118 8.5.1 Внутренняя таблица 119 8.5.2 Внешняя таблица 119 8.6 Встроенная -В функции и пользовательской функции 121 8.6.1 -Встроенный -в экземпляре функции 121 8.6.2 Пользовательский экземпляр функции UDAF 123 8.7 Посетите Hive 124 через Java 8.8 Оптимизация уля 125 8.8.1 Оптимизация MapReduce 126 8.8.2 Оптимизация конфигурации 126 8.9 Маленький финал 127 Глава 9 Большие данные быстро прочитайте и пишите——HBase 128 9.1 о nosql 128 9.1.1 Что такое nosql 128 9.1.2 Классификация базы данных NOSQL 129 9.1.3 Применение базы данных NOSQL 129 9.1.4 Разница между реляционной базой данных и нереляционной базой данных 130 9.2 HBASE BASIC 130 9.2.1 Введение в HBASE 130 9.2.2 Модель данных HBASE 131 9.2.3 Архитектура и компонент HBASE 132 9.2.4 Принцип исполнения HBase 134 9.3 Установка HBASE 135 9.4 Работа HBASE 138 9.5 Java API посетите HBASE Пример 139 9.5.1 Создание таблицы 139 9.5.2 Вставьте данные 140 9.5.3 Данные запроса 141 9.6 Резюме 142 Глава 10 Массовый инструмент сбора журналов——Flume 143 10.1 Что такое Flume 143 10.2 Особенности Flume 143 10.3 Архитектура Flume 144 10.4 Основной компонент Flume 144 10.4.1 Событие, клиент и агент—— 10.4.2 Source— 10.4.3 Channel— 10.4.4 Sink— 10.4.5 Другие компоненты 148 10.5 Установка Flume 148 10.6 Пример приложения Flume Типичный пример 149 10.6.1 Локальное чтение данных (Conf1) 149 10.6.2 Соберите в HDFS 150 10.6.3 Сбор данных на основе данных 152 10.7 Реализуйте сбор данных через команду EXEC 153 10.7.1 Инструмент установки 153 10.7.2 Редактировать файл конфигурации Conf4 155 10.7.3 запустить Flume 156 10.7.4 Просмотреть сгенерированный файл 156 10.7.5 Просмотреть данные в HDFS 157 10.8 Резюме 158 Глава 11 Инструменты передачи данных между Hadoop и смежными базами данных——Sqoop 159 11.1 Что такое SQOOP 159 11.2 СВОП -механизм 159 11.3 Установка и конфигурация SQOOP 161 11.3.1 Скачать SQOOP 161 11.3.2 Конфигурация SQOOP 162 11.4 SQOOP DATA ВВЕДЕНИЕ ЭНТЕРСО 163 11.4.1. 11.4.2 Импорт данных в улья 167 11.4.3 Результаты руководства в HDFS 170 11.5 Пример экспорта данных SQOOP 172 11.6 Резюме 173 Глава 12 Распределенное квест сообщений——Kafka 174 12.1 Что такое Кафка 174 12.2 Архитектура и основной компонент Кафки 174 12.2.1 Имя категории записи сообщества——Topic 175 12.2.2 Производитель и потребитель—— 12.2.3 Другие компоненты—— 12.3 Скачать и кластерная установка Kafka 177 12.3.1 Скачать и декомпрессия пакета установки 177 12.3.2 Конфигурация установки KAFKA 178 12.4 Приложение Cafka Exmance 181 12.4.1 Экземпляр производителя 181 12.4.2 Инстанция потребителя 182 12.5 Резюме 184 Глава 13 База данных памяти с открытым исходным кодом——Redis 185 13.1 Введение в Redis 185 13.1.1 Что такое Redis 185 13.1.2 Особенности Redis 186 13.2 Установка и конфигурация Redis 186 13.3 Клиентский логин 187 13.3.1 Пароль - пустая посадка 187 13.3.2 Установите пароль. Вход 188 13.4 Тип данных Redis 188 13.4.1 Тип строки 188 13.4.2 Тип типа 190 13.4.3 Хэш тип 191 13.4.4 Set Type 194 13.5 Резюме 197 Глава 14 Амбари и CDH 198 14.1 Амбари Установка и управление кластером 198 14.1.1 Знай HDP и Ambari 198 14.1.2 Ambari Construction 199 14.1.3 Настройте сетевую карту и измените имя машины 199 14.1.4 Определите взаимосвязь между DNS -сервером и изменяйте отображение хоста Hosts 200 14.1.5 Выключите брандмауэр и установите JDK 200 14.1.6 Обновление протокола с конвергенцией openssl версии 201 версии 201 версии 201 14.1.7 Выключите Selinux Control Access 201 14.1.8 SSH -пароль -free Login 202 14.1.9 Синхронный NTP 202 14.1.10 Выключите службу THP Linux 204 14.1.11 Настройка Umask и HTTP Service 204 14.1.12 Установите инструменты, связанные с производством локального источника и Createrepo 205 14.1.13 Запретить в автономном обновлении и производстве локальный источник 205 14.1.14 Установить Ambari-Server и MySQL 208 14.1.15 Установить Ambari 210 14.1.16 Установите агент и вход и установка Ambari 211 14.1.17 Установка и задача развертывания Решение 214 14.2 CDH Установка и управление кластером 216 14.2.1 Что такое CDH и Cloudera Manager введение 216 14.2 Сравнение Cloudra Manager с Ambari 216 14.2.3 CDH Установка и конфигурация сетевой карты 217 14.2.4 Измените имя и определение машины DNS Server 217 14.2.5 Модифицировать отношения хоста Хост. Отношения 218 14.2.6 Закрыть брандмауэр 218 14.2.7 Установить JDK 219 14.2.8 Обновление OpenSSL Construction Layer Edition 219 14.2.9 Отключить функцию обязательного доступа Selinux 220 14.2.10 SSH -пароль -Free Login 220 14.2.11 Синхронная установка NTP 220 14.2.12 Установить MySQL 222 14.2.13 Установить Cloudra Manager 222 14.2.14 Добавить пакет драйверов MySQL и изменить конфигурацию агента 223 14.2.15 Инициализируйте базу данных CM5 и создайте пользователь 223 Cloudera-SCM 223 14.2.16 Подготовка посылок 223 14.2.17 Конфигурация установки CDH 224 14.3 Резюме 227 Глава 15 Быстрая и общая кластерная вычислительная система——Spark 228 15.1 Spark Basic знания 228 15.1.1 Особенности Spark 228 15.1.2 Сравнение Spark and Hadoop 229 15.2 Эластичный распределенный набор данных RDD 230 15.2.1 Концепция RDD 230 15.2.2 Метод создания RDD 230 15.2.3 Операция RDD 230 15.2.4 Процесс выполнения RDD 231 15.3 Механизм эксплуатации искры 232 15.4 Spark 233 Бег на пряже 15.4.1 Run Spark 233 на пряже 15.4.2 Два режима развертывания Spark на пряже 233 15.5 Spark Cluster Установка 234 15.5.1 Скачать пакет установки Spark 234 15.5.2 Среда установки Spark 236 15.5.3 Установка и конфигурация Scala 236 15.5.4 Настройка распределенного кластера. 15.6. Подробное объяснение экземпляра Spark 241 15.6.1 Статистика URL -адресов с наибольшим количеством пользователей веб -сайтов 241 15.6.2 Примеры географического позиционирования пользователя 243 15.7 Резюме 246 Статья 3 Hadoop Case Case Cash Combat Глава 16 Фактическая борьба с системой бизнес -анализа больших данных на основе продуктов E -Commerce 248 16.1. 16.2 Функция и процесс 249 16.2.1 Информация пользователя 250 16.2.2 Информация о товаре 251 16.2.3 Запись о покупке 251 16.3 Сбор данных 252 16.3.1 Файл конфигурации Flume 252 16.3.2 Start Flume 253 16.3.3 Просмотр собранного файла 253 16.3.4 Просмотр файла 254 через фоновую команду 254 16.3.5 Просмотреть содержимое файла 255 16.3.6 Загрузить user.list Файл 256 16.3.7 Загрузить каталог бренда. 16.4 Предварительная обработка данных 257 16.5 Анализ данных—— 16.6 Установите модель 264 16.6.1 Общее потребление пользователя каждой возрастной группы 264 16.6.2 Запрос о общих продажах каждого бренда 265 16.6.3 Расследование об общем потреблении каждой провинции 266 16.6.4 Используйте SQOOP для импорта данных в базу данных MySQL 266 16.7 Визуализация данных 268 16.8 Резюме 272 Глава 17 Анализ портрета пользователя 273 17.1 Проект Фон 273 17.2 Цели проекта и процесс разработки проекта 274 17.2.1 Сбор данных 274 17.2.2 Предварительная обработка данных 275 17.2.3 Строительство модели 275 17.2.4 Анализ данных 276 17.3 Интерпретация базового кода 277 17.3.1 Введение проекта 277 17.3.2 Интерпретация основного класса 278 17.3.3 Файл конфигурации Core-site.xml 279 17.3.4 Файл конфигурации HDFS-site.xml 279 17.3.5 userprofile.properties Файл конфигурации 280 17.3.6 LoadConfig.java: Прочтите информацию о конфигурации 280 17.3.7 readfile.java: Read File 281 17.3.8 Readfromhdfs.java: извлечение информации 281 17.3.9 userprofile.java: Создать пользовательский портрет 282 17.3.10 TextArrayWrable.java: инструмент обработки строки класс 285 17.3.11 MapReduce Задача 1: userprofilemapreduce.java 285 17.3.12 MapReduce Задача 2: userProfilEmapreduce2.java 289 17.3.13 userprofileputinhbasemap.java: извлечь пользовательский портрет 291 17.3.14 userProfilePutinhbasereduce: Портрет пользователя хранилища 292 17.4 Развертывание проекта 293 17.5 Резюме 294 Глава 18 Персонализированная система видео рекомендаций Real Combat 295 18.1 Проект Фон 295 18.2 Введение в целей проекта и системы рекомендаций 295 18.2.1 Классификация рекомендуемой системы 295 18.2.2 Процесс строительства рекомендуемой модели 296 18.2.3 Основной алгоритм системы рекомендаций 297 18.2.4 Как выполнить рекомендацию по продукту 300 на основе фреймворта Mahout 18.2.5 Пример товарных рекомендаций 300 на основе фреймворта 300 Махоут 300 18.3 Рекомендуемая система проекта. Архитектура 302 18.4 Рекомендую системную модель конструкции 303 18,5 CORE 304 18.5.1 Общественная часть 305 18.5.2 Offline Part 307 18.5.3 Онлайн часть 311 18.6 Резюме 314 Глава 19 Телекоммуникации вдали от интернет -пользователей сохраняют фактический бой 315 19.1 Понимание бизнеса 315 19.2 Понимание данных 316 19.2.1 Соберите данные 316 19.2.2 Понять данные 317 19.2.3 Гарантия качества данных 318 19.3 Организация данных 318 19.3.1 Интеграция данных 318 19.3.2 Фильтр данных 319 19.4 Очистка данных 319 19.4.1 распознавание шума 320 19.4.2 Определение отъезда и экстремального значения 321 19.4.3 Метод лечения групповой стоимости 321 19.4.4 Пример обработки значения воздуха данных 323 19.5 Преобразование данных 324 19.5.1 Преобразование переменной 324 19.5.2 Классификация классификации сжатия 324 19.5.3 Непрерывные данные дискретные 325 19.5.4 Изменить глупую переменную 326 19.5.5 Стандартизация данных 326 19.5.6 Сжатие данных 326 19.6 Моделирование 327 19.6.1 Обзор алгоритма дерева решений 327 19.6.2 ОБУЧЕНИЯ ШАГИ Дерева решений 327 19.6.3 Дерево решений обучения 328 19.6.4 C4.5 Алгоритм 329 19.6.5 Ветви дерева решений 332 19.7 Оценка 335 19.7.1 Матрица путаницы 335 19.7.2 ROC Curve 336 19.8 Развертывание 338 19.9 Подробное объяснение случая пользователя вдали от сети 339 19.9.1 Подготовка данных 339 19.9.2 Связанный анализ 341 19.9.3 Окончательное моделирование 342 19.9.4 Оценка модели 343 19.10 Резюме 346 |
 |
| Изучите анализ больших данных Hadoop с нуля (версия для обучения видео) Wen Chunshui bi jiexin скомпилирован Номер книги: 978-7-111-61931-4 Индийский Чжан: 23 (всего 368) Книжный хребет: 17 мм Цена: 89,00 юаней. Размер готового продукта: 186*240 мм Печать: 3500 объемов Желе: компьютер/большие данные |
Книги, продаваемые в этом магазине, являются настоящими книгами