


8 (905) 200-03-37 Владивосток
с 09:00 до 19:00
CHN - 1.14 руб. Сайт - 21.13 руб.

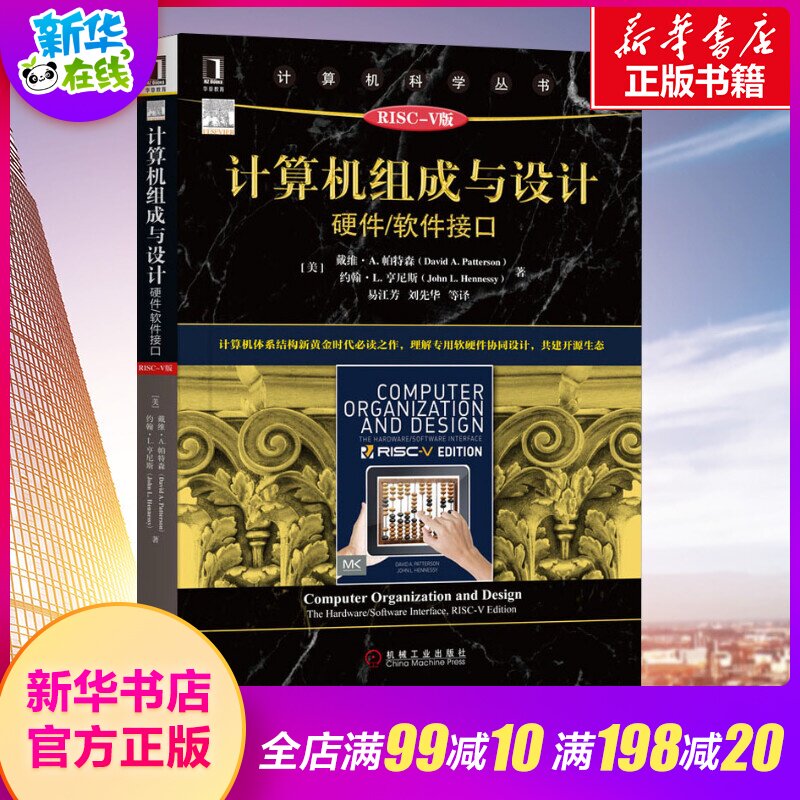
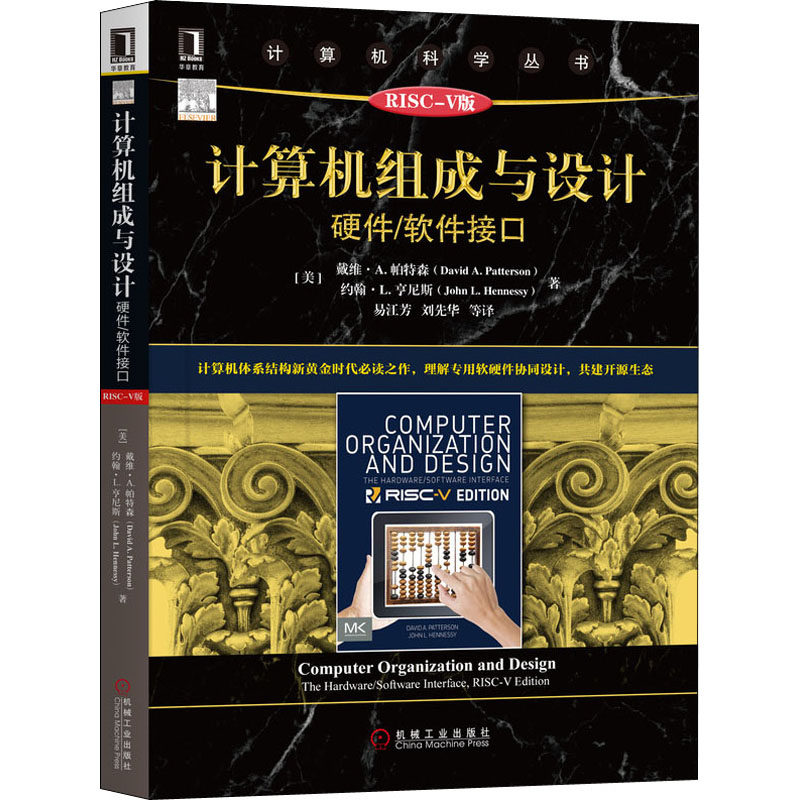
Композиция компьютера и дизайна аппаратного/программного интерфейса (оригинальная книга 5) версия RISC-V (США) Дэвид А. Патсон, (США) Джон Л. Хеннис Йи Цзянфанг и другие переводы

Цена: 2 606руб.    (¥123.3)
Артикул: 620658026850

Вес товара: ~0.7 кг. Указан усредненный вес, который может отличаться от фактического. Не включен в цену, оплачивается при получении.

Этот товар на Таобао Описание товара
Продавец:新华在线图书专营店
Рейтинг:
Всего отзывов:0
Положительных:0
Добавить в корзину
Другие товары этого продавца
¥16.4347руб.
¥55.121 165руб.
¥3206 740руб.
¥63.221 336руб.

Композиция компьютера и проектирования аппаратного/программного интерфейса (оригинальная книга 5) RISC-V

сделать   автор:(США) Дэвид&миддот; А. Паттерсон, (США) Джон&миддот Л. Хеннесси в переводе И Цзянфана и других
решительный  Цена:169
из&энсп; версия&энсп; агентство:Машиностроительная промышленность Пресса
Дата публикации:1 мая 2020 г.
страница  Количество:470
установить  Рамка:Мягкая обложка
ISBN:9787111652144
Каталог
●Издатель
Хвалить
Переводчик
Предисловие
Об авторе
Глава Компьютерная абстракция и связанные с ней методы 1
1.1 Введение 1
1.1.1 Классификация традиционных вычислительных приложений и их характеристики 2
1.1.2 Добро пожаловать в Post -pc Era 3 3
1.1.3 Чему вы можете научиться из этой книги 4
1.2 8 замечательных идей в компьютерной архитектуре 6
1.2.1 Схема закона Мура 6
1.2.2 Использование абстракции для упрощения проектирования 7
1.2.3 Ускорение повторяющихся событий 7
1.2.4 Улучшение производительности через параллель 7
1.2.5 Улучшение производительности через сборку 7
1.2.6. Повышение производительности с помощью прогнозирования 7
1.2.7 Иерархия хранения 7
1.2.8 Улучшить надежность с помощью избыточности 7
1.3 Программирование 8
Аппаратное обеспечение после 1,4 коробок 10
1.4.1 Дисплей 11
1.4.2 Сенсорный экран 12
1.4.3 Откройте шасси 13
1.4.4 Безопасность данных 16
1.4.5 Связь с другими компьютерами 16
1.5 Технология производства процессоров и накопителей 17
1.6 Производительность 20
1.6.1 Определение производительности 21
1.6.2 Показатели эффективности 23
1.6.3cpu производительность и его коэффициенты измерения 24
1.6.4 Выполнение инструкций 25
1.6.5 Classic CPU Performance Formula 26
1.7 Энергопотребление Стена 28
1.8 Гигантские изменения: переход от одного процессора к многопроцессору к мульти -процедуру 30
1.9 Пример: оценка IntelCorei732
1.9.1speccpu Программа оценки эталона 33
1.9.2 Программа сравнительной оценки энергопотребления SPEC 34
1.10 Заблуждения и подводные камни 35
1.11 Краткое содержание главы 37
1.12 Историческая перспектива и дальнейшее чтение 38
1.13 Упражнение 38
Глава 2. Инструкции: Язык компьютеров 43
2.1 Введение 43
2.2 Работа компьютерного оборудования 45
2.3 Операнды компьютерного оборудования 47
2.3.1 Операнды памяти 48
2.3.2 Постоянные или непосредственные операнды 51
2.4 Количество символов и не -символов 52
2.5 Представление инструкций в компьютерах 57
2.6 Логические операции 62
2.7 Инструкции по принятию решений 65
2.7.1 Циклы 66
2.7.2 Удобный метод проверки границ 67
2.7.3 оператор случая/переключателя 68
2.8 Аппаратная поддержка процессов 68
2.8.1 Использование дополнительных регистров 69
2.8.2 Вложенные процедуры 71
2.8.3 Пространство распределения данных в стеке 73
2.8.4 Пространство подписания для новых данных в куче 74
2.9 Взаимодействие человека и компьютера 76
2.10 Адресация RISC-V и адресация больших непосредственных номеров 79
2.10.1 Большие немедленные данные 79
2.10.2 Обращение в филиалах 80
2.10.3 Обзор режимов адресации RISC-V 82
2.10.4 Декодирование машинного языка 83
2.11 Инструкции и параллелизм: синхронизация 85
2.12 Перевести и запустить программу 87
2.12.1 Компиляторы 87
2.12.2 Ассемблер 87
2.12.3 Линкер 89
2.12.4 Погрузчики 91
2.12.5 Библиотеки динамической компоновки 91
2.12.6 Запуск программы Java 93
2.13 Суммирование на примере программы сортировки C 94
2.13.1 процесс обмена 94
2.13.2 процесс сортировки 95
2.14 массив и указатель 100
2.14.1 Реализация Clear100 с массивом
2.14.2 Используйте указатель для реализации Clear101
2.14.3 Сравните две версии Clear102
2.15 Хорошая тема: компиляция C и интерпретация Java 102
2.16 Пример: инструкции MIPS 103
2.17 Примеры: инструкции x86 104
2.17.1 Эволюция Intel x86 104
2.17.2x86 Регистры и режимы адресации 106
2.17.3 Целочисленные операции x86 107
2.17.4 Кодирование инструкций x86 109
2.17.5x86 Резюме 110
2.18 Пример: оставшаяся часть системы инструкций RISC-V 111
2.19 Заблуждения и подводные камни 112
2.20 Краткое содержание главы 113
2.21 Историческая перспектива и дальнейшее чтение 115
2.22 Упражнение 115
Глава 3. Арифметические операции для компьютеров 121
3.1 Введение 121
3.2 Сложение и вычитание 121
3.3 Умножение 124
3.3.1 Алгоритм умножения и их аппаратная реализация серийной версии 124
3.3.2 Знаковое умножение 127
3.3.3 Быстрое умножение 127
3.3.4 Умножение в RISC-V 127
3.3.5 Резюме 128
3.4 Дивизия 128
3.4.1 Алгоритм деления и его аппаратная реализация 128
3.4.2 Метод удаления символа 131
3.4.3 Быстрый дивизион 131
3.4.4 Деление в RISC-V 132
3.4.5 Резюме 132
3.5 Арифметика с плавающей запятой 133
3.5.1 Представление с плавающей запятой 134
3.5.2 Исключения и прерывания 135
3.5.3ieeee754 Номер плавающей запятой Стандарт 135
3.5.4 Сложение чисел с плавающей запятой 138
3.5.5 Умножение с плавающей запятой 141
3.5.6 Инструкции с плавающей запятой в RISC-V 144
3.5.7 Точная арифметика 148
3.5.8 Резюме 150
3.6 Параллелизм и компьютерная арифметика: суб -характер Параллель 151
3.7 Примеры: расширения SIMD и векторные расширения Nice в x86 151
3.8 Ускорение: параллельный и матричный размножение матрицы 153
3.9 Заблуждения и подводные камни 155
3.10 Краткое содержание главы 158
3.11 Историческая перспектива и дальнейшее чтение 159
3.12 Упражнение 159
Глава 4 Процессоры 163
4.1 Введение 163
4.1.1 Базовая реализация RISC-V 164
4.1.2 Обзор реализации 164
4.2 Общий подход к проектированию логики 166
4.3 Установление пути данных 169
4.4 Простой план реализации 175
4.4.1 Управление АЛУ 175
4.4.2.
4.4.3 Операции с трактом данных 180
4.4.4 Конец контроля 182
4.4.5 Почему он не используется за один цикл сейчас 182
4.5 Обзор конвейерной обработки 183
4.5.1 Проектирование системы инструкций для строки сборки 187
4.5.2 Приключения на трубопроводе 187
4.5.3 Резюме 193
4.6 Конвейерный путь передачи данных и управление 194
4.6.1 Графическое представление трубопровода 203
4.6.2 Управление трубопроводом 205
4.7 Приключения с данными: вперед и паузы 208
4.8 Управление приключениями 218
4.8.1 Предполагая, что ветвления не происходит 218
4.8.2 Уменьшение задержки ветвления 219
4.8.3 Динамическое предсказание ветвей 221
4.8.4 Сводная информация о конвейере 223
4.9 Исключения 223
4.9.1 Как обрабатываются исключения в архитектуре RISC-V 224
4.9.2 Исключения в конвейерных реализациях 225
4.10 Параллелизм между инструкциями 228
4.10.1 Понятие спекуляции 229
4.10.2 Статические многократные пуски 230
4.10.3 Динамический многозадачный процессор 234
4.10.4 Хорошие трубопроводы и энергоэффективность 237
4.11 Пример: структура конвейера ARM Cortex-A53 и IntelCorei7 238
4.11.1ARMCortex-A53238
4.11.2IntelCorei7920240
4.11.3 Производительность процессора Intel Core i7 242
4.12 Ускорение: параллелизм на уровне инструкций и умножение матриц 243
4.13 Хорошая тема: Обзор цифрового дизайна——Моделирование конвейеров с помощью языка проектирования аппаратного обеспечения и дополнительные примеры конвейеров 246
4.14 Заблуждения и подводные камни 246
4.15 Краткое содержание главы 247
4.16 Историческая перспектива и дополнительная литература 247
4.17. Упражнение 247.
Глава 5. Большие и быстрые: иерархическое хранилище 258
5.1 Введение 258
5.2 Технология хранения 262
5.2.1 Технология хранения SRAM 262
5.2.2 Технология хранения DRAM 262
5.2.3 Вспышка 264
5.2.4 Диск 264
5.3 Основы кэширования 266
5.3.1 доступ к кэшу 268
5.3.2 Обработка промахов в кэше 272
5.3.3 Обработка операций записи 273
5.3.4 Экземпляр кэша: процессор IntrinsityFastMATH 275
5.3.5 Резюме 276
5.4 Оценка и улучшение производительности кэша 277
5.4.1 Используйте более гибкую стратегию замены, чтобы снизить частоту промахов кэша 279
5.4.2 Поиск блоков данных в кэше 283
5.4.3 Выбор блоков данных для замены 284
5.4.4 Используйте многоуровневый кеш, чтобы уменьшить сбой 285
5.4.5 Оптимизация программного обеспечения путем разбиения на части 287
5.4.6 Резюме 291
5.5 Иерархия надежной памяти 291
5.5.1 Определение неисправности 291
5.5.2 Кодирование Хэмминга для исправления 1-битных ошибок и обнаружения 2-битных ошибок 293
5.6 Виртуальные машины 296
5.6.1 Основное условие для монитора виртуальной машины 297
5.6.2 Архитектура системы инструкций (не хватает) поддержка виртуальных машин 297
5.6.3 Архитектура системы защиты и обучения 298
5.7 Виртуальное хранилище 298
5.7.1 Хранение и поиск страниц 301
5.7.2 Ошибки страниц 303
5.7.3 Виртуальное хранилище, поддерживающее большие виртуальные адресные пространства 304
5.7.4 О написании 305
5.7.5 Ускорение трансляции адресов: TLB306
5.7.6IntrinsityFastMATHTLB307
5.7.7 Интеграция виртуального хранилища, TLB и кэша309
5.7.8 Защита в виртуальном хранилище 311
5.7.9 Обработка ошибок TLB и ошибок страниц 312
5.7.10 Резюме 314
5.8 Общая структура иерархий хранения 315
5.8.1 Вопрос 1: Где можно размещать блоки 315
5.8.2 Вопрос 2: Как найти блок 316
5.8.3 Вопрос 3: Какой блок заменить при сбое кэша 317
5.8.4 Вопрос 4: Как обращаться с операциями записи 317
5.8.53C: Интуитивная модель для понимания иерархии хранения 318
5.9 Используйте автоматическую машину с ограниченным состоянием для управления Simple Cache320
5.9.1 Простой Cache320
5.9.2. Автоматическая машина с ограниченным состоянием 321
5.9.3 Используйте автоматическую машину с ограниченным состоянием в качестве простого контроллера кэша 322
5.10 Параллелизм и иерархии хранения: согласованность кэша 324
5.10.1 Базовая схема достижения согласованности 325
5.10.2 Протокол прослушивания 325
5.11 Параллелизм и иерархия хранения: избыточные массивы недорогих дисков 327
5.12 Хорошая тема: реализация контроллера кэша 327
5.13 Пример: иерархия хранилища для ARM Cortex-A53 и Intel Core i7 327
5.14 Пример: другие детали и специальные инструкции системы RISC-V 331
5.15 Ускорение: блокировка кэша и умножение матриц 331
5.16 Заблуждения и подводные камни 333
5.17 Краткое содержание главы 336
5.18 Историческая перспектива и дальнейшее чтение 337
5.19. Упражнение 337.
Глава 6. Параллельные процессоры: от клиента к облаку 348
6.1 Введение 348
6.2 Трудности создания программ параллельной обработки 350
6.3 SISD, MIMD, SIMD, SPMD и векторные машины 354
6.3 SIMD в 1x86: мультимедийные расширения 355
6.3.2 Векторные машины 355
6.3.3 Vector и Scalar 356
6.3.4 Векторные и мультимедийные расширения 357
6.4 Аппаратная многопоточность 359
6.5 Multi -Core и другие общими памятью Multi -Processor 362
6,6GPU Введение 365
6.6.1nvidiagpu Архитектура Введение 366
6.6.2NVIDIAGPU Структура хранения 367
6.6.3 Outlook на GPU 368
6.7 Кластеры, компьютеры складского класса и другие мультипроцессоры передачи сообщений 370
6.8 Введение в топологии многопроцессорных сетей 374
6.9 Связь с внешним миром: кластерные сети 376
6.10 Тесты многопроцессорных процессоров и модели производительности 377
6.10.1 Модели производительности 379
6.10.2 Линия крыши модели 380
6.10.3 Сравнение двух поколений Opteron 381
6.11 Пример: просмотрите модель линии крыши Intelcorei7960 и Nvidiateslagpu 384
6.12 Ускорение: мультипроцессоры и умножение матриц 388
6.13 Заблуждения и подводные камни 390
6.14 Краткое содержание главы 391
6.15 Историческая перспектива и дальнейшее чтение 393
6.16. Упражнение 394.
Приложение А. Основы проектирования логики 402
Глоссарий 460
Сетевой контент
Приложение B Графическая обработка
Приложение C связывает управление с аппаратным обеспечением
Приложение D Упрощенная архитектура инструкции архитектура инструкций
Расширенное чтение
Содержание пунктирное

Введение в контент

Эта книга была написана лауреатом премии Тьюринга 2017 года Паттерсоном и Хеннесси. Это классическая книга в структуре компьютерной архитектуры, подчеркивающая скоординированный дизайн программного обеспечения и оборудования и ее влияние на производительность.В этой книге используется архитектура системы инструкций RISC-V с открытым исходным кодом для объяснения аппаратной технологии, языка сборки, арифметических операций, сборочных линий, уровней хранения, ввода-вывода и параллельных процессоров.Новый контент охватывает планшеты, облачную инфраструктуру, архитектуру ARM (мобильное вычислительное устройство) и X86 (облачные вычисления). Новые примеры включают в себя GPU Intel Core I7, ARM Cortex-A53 и Nvidia Fermi.Эта книга подходит для профессионального и технического персонала в области компьютерной архитектуры, а также подходит для студентов, связанных с компьютером в колледжах и университетах для чтения.