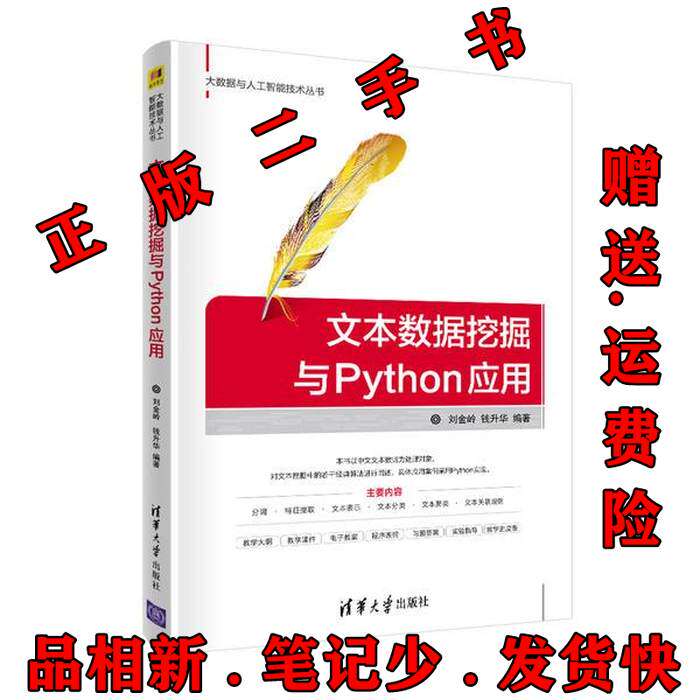
Второе -приложение для добычи текстовых данных и Python
Цена: 296руб. (¥13.99)
Артикул: 698093013224
Вес товара: ~0.7 кг. Указан усредненный вес, который может отличаться от фактического. Не включен в цену, оплачивается при получении.
Описание товараПродавец:便宜东西专用户
Рейтинг:
Всего отзывов:0
Положительных:0
Добавить в корзину
Другие товары этого продавца


¥27.24576руб.
¥ 12.62 11.99254руб.
¥12.88273руб.
¥ 6.19 5.88125руб.

Основная информация
Название: Maning Text Data и приложение Python
Цена: 49,8 юань
Автор: Liu Jinling Qian Sales
Пресса: издательство Tsinghua University Press
Дата публикации: февраль 2021 г.
ISBN:9787302557869
Номер страницы: 196
Вес товара: пока нет информации о количестве страниц
Выбор редактора
нет информации
Краткое содержание
教材系统地介绍文本数据挖掘的相关概念 , 利用 Python 作为工具进行相关试验 , : 文本挖掘产生的背景及发展;文本挖掘的概念、文本模型表示、文本内容的预处理 , 包括分词、 Прекратите слова и извлечение функций;Введите концепции и общие методы классификации текста, такие как алгоритм KNN, алгоритм SVM и т. Д., И оценить результаты классификации; , многослойная кластеризация в качестве приложения с текстовой классификацией и кластеризацией текста, методом классификации, методом кластеризации плотности и т. Д., В конце концов, давая извлечение информации, извлечение физических отношений и извлечение событий в социальных сетях.
Каталог
Каталог
Скачать исходный код
Глава 1. Введение
1.1 Исследуйте фон и значение добычи текста
1.2 Статус внутренних и иностранных исследований дома и за рубежом
1.3 Резюме для добычи текста
1.3.1 Концепция добычи текста
1.3.2 Задача добычи текста
1.3.3 Различия и различия между интеллектуальным анализом и интеллектуальным анализом данных
1.4 Процесс добычи текста
1.5 Основная исследовательская область добычи текста
1.5.1 Выбор текстовой функции
1.5.2 Анализ структуры текста
1.5.3 Сводка текста
1.5.4 Текстовая классификация
1.5.5 Текстовый кластер
1.5.6 Анализ текстовой ассоциации
1.5.7 Анализ распределения и прогнозирование тенденций
1.6 Случаи применения текста в фармацевтической промышленности
Упражнение 1
Глава 2 точки резки текста и выбор слов
2.1 Сбор текстовых данных
2.1.1 Метод стыковки программного интерфейса
2.1.2 Открыть метод базы данных
2.1.3 Прямой метод сбора на основе обмена данными
2.1.4.
2.2 Введение в Corghelies и Dictionary
2.2.1 Библиотека корпуса
2.2.2 Словарь
2.3 Точки резки текста
2.3.1 Точки вырезания предложения
2.3.2 Словарь
2.4 Выбор текстовых функций
2.4.1 Обзор текстовых функций слов
2.4.2 Метод выбора слов общего текста
2.5Python Jieba word split module и его использование
2.5.1 МЕТОД
2.5.2 -На основе правил китайских слов
2.5.3 Извлечение ключевых слов
Упражнение 2
Глава 3 Text Express Model
3.1
3.1.1 Примитивная обработка данных
3.1.2.
3.2 Vanguard Space Model
3.2.1 Концепция модели векторного пространства
3.2.2 Сходство текстовых векторов
3.2.3 Реализация Python векторной модели
3.3 модель вероятности
3.3.1 Обзор модели вероятности
3.3.2 Метод вероятности моделирования
3.3.3 Модель вероятности в поиске текстовой информации
3.3.4 Реализация модели вероятности Python
3.4 Модель темы вероятности
3.4.1 Обзор модели темы вероятности
3.4.2PLSA модель темы вероятности
3.4.3 LLDA модель темы вероятности
3.4.4lda Python Реализация модели темы вероятности
Упражнение 3
Глава 4 Классификация
4.1 Обзор текстовой классификации
4.1.1 Значение исследований
4.1.2 Тенденции статуса и развития дома и за рубежом
4.1.3 Определение текстовой классификации
4.1.4 Процесс классификации текста
4.1.5.
4.2 Общие текстовые классификаторы
4.2.1 KNNN Classifier
4.2.2SVM Классификатор
4.2.3Rocchio Classifier
4.2.4 Простой байесовский классификатор
4.2.5 Классификатор дерева решений
4.3 Оценка эффективности модели классификации
4.3.1 Метод оценки классификации
4.3.2 Индекс оценки эффективности классификации
Упражнение 4
Глава 5 Культурное кластер
5.1 Сводка текстовой кластеризации
5.1.1 Значение исследований
5.1.2 Тенденции статуса и развития дома и за рубежом
5.1.3 Определение текстового кластера
5.1.4 Текстовый кластерный процесс
5.1.5 Требования к производительности для кластерных алгоритмов
5.2 Принцип и метод текстового кластера
5.2.1 На основе методов деления
5.2.2 Слоистый метод
5.2.3 Метод на основе плотности
5.2.4 Метод на основе сетки
5.2.5 Метод на основе модели
5.3 Оценка текстового кластера
5.3.1 Тенденции кластеров оценки
5.3.2 Определить номер кластера
5.3.3 Измерение качества кластера
Упражнение 5
Глава 6 Анализ текстовых отношений
6.1 Обзор соответствующих правил.
6.2 Правила, связанные с текстом
6.2.1 Основная концепция правил ассоциации
6.2.2 Классификация правил ассоциации
6.3 Алгоритм добычи правил ассоциации
6.3.1Apriori Алгоритм
6.3.2FPGROWTH Алгоритм
Упражнение 6
Глава 7 Используйте Python для обработки текстовых данных простое приложение
7.1 Эмоциональный анализ
7.1.1 Принципы эмоционального анализа
7.1.2 Дизайн алгоритма
7.1.3 Реализация алгоритма
7.2 Автоматически генерировать ключевые слова и рефераты
7.2.1textrank Algorithm
7.2.2 Сгенерировать ключевые слова и рефераты
7.3 Используйте Snapownlp для оценки продукта
7.3.1snownlp Библиотека Введение
7.3.2snownlp Оценка продукта
7.4 Сгенерировать "Ci Cloud"
7.4.1 Концепция "Ci Cloud"
7.4.2Python "Ci Cloud"
Упражнение 7
Рекомендации
об авторе
Лю Джинлинг, профессор, репетитор Мастера.К 2007 году были проведены исследования по интеллектуальному анализу текстовых данных, опубликованные более 30 связанных статей в профессиональных основных журналах, 4 EI поиска и 3 SCCSI -поиска.В 2010-2013 годах он сотрудничал с Jiangsu Mobile Corporation для проведения исследований по обработке спама.
