



8 (905) 200-03-37 Владивосток
с 09:00 до 19:00
CHN - 1.14 руб. Сайт - 21.13 руб.

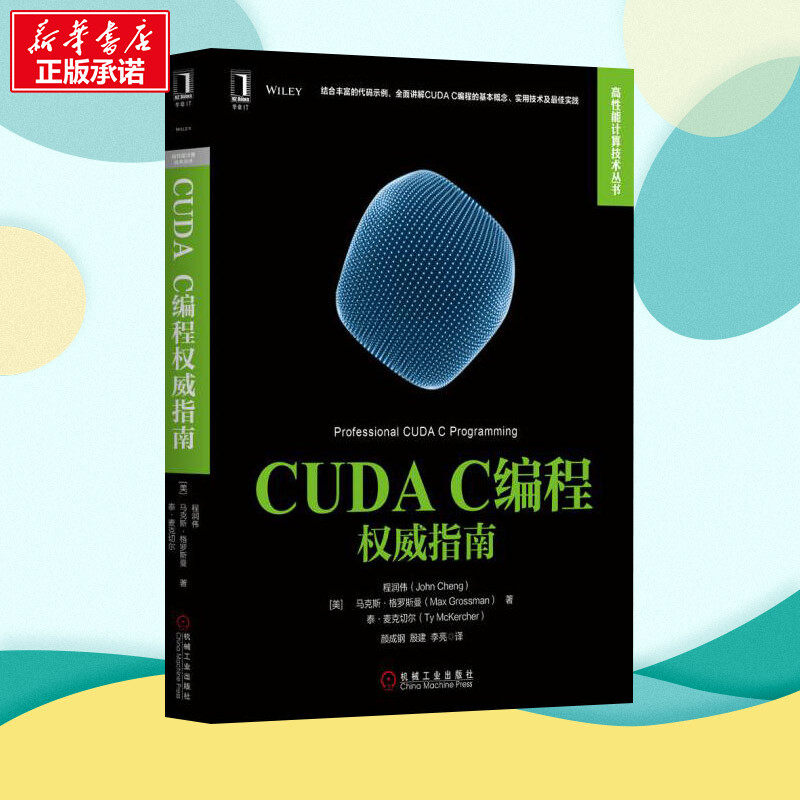
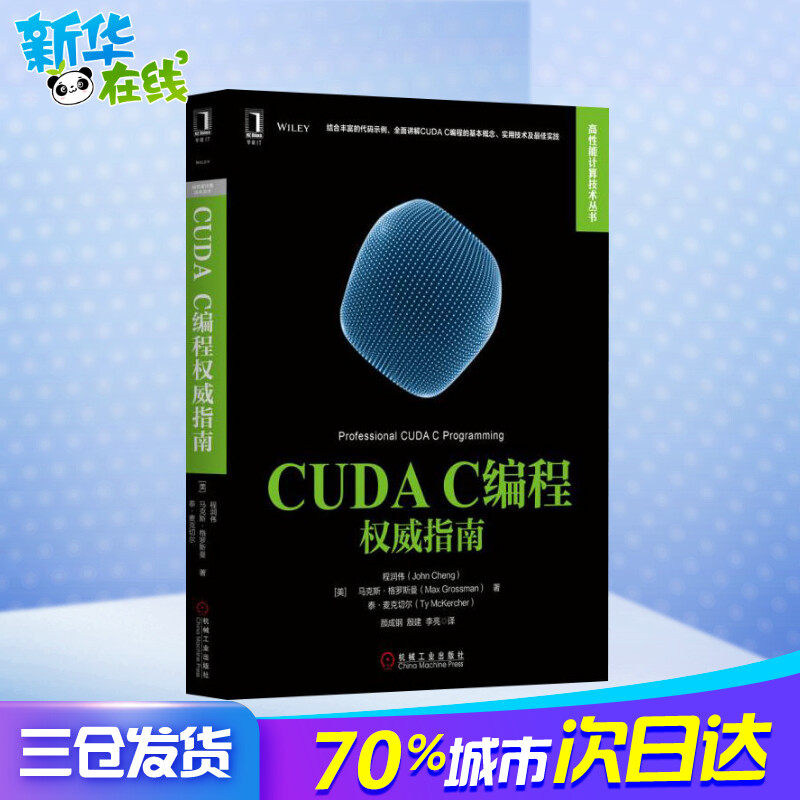
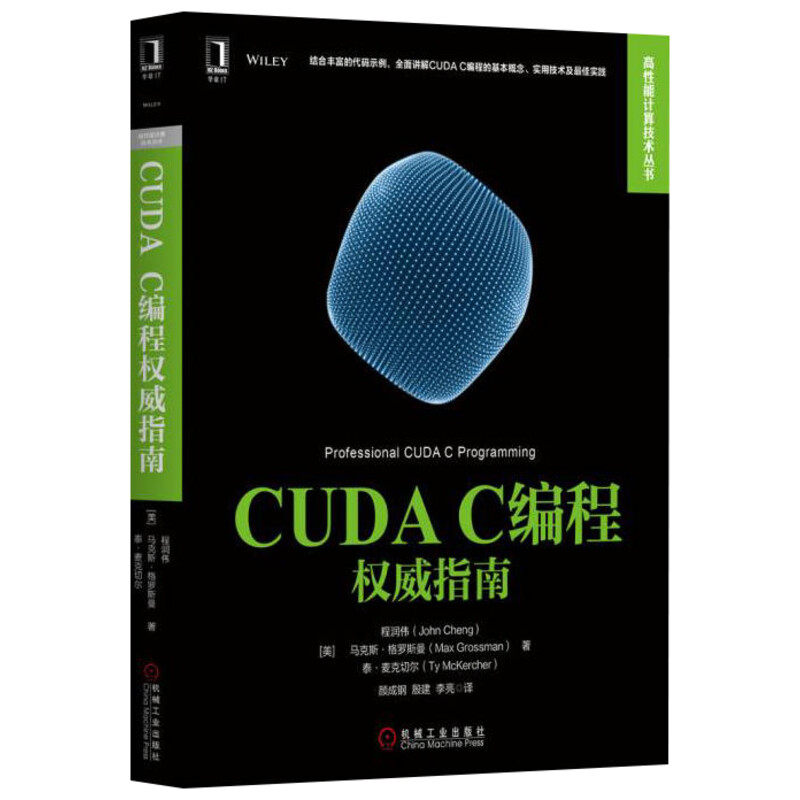
Авторитетное руководство по программированию CUDA C (США) от John Cheng et al.;

Цена: 1 235руб.    (¥58.41)
Артикул: 553272027688

Вес товара: ~0.7 кг. Указан усредненный вес, который может отличаться от фактического. Не включен в цену, оплачивается при получении.

Этот товар на Таобао Описание товара
Продавец:华夏盛轩图书专营店
Рейтинг:
Всего отзывов:0
Положительных:0
Выберите вариацию / цвет
Добавить в корзину
Другие товары этого продавца
¥45.69966руб.
¥136.12 876руб.
¥47.71 008руб.
¥ 94.4 84.891 794руб.
Регулирование: Руководство по программированию CUDA C

Руководство по программированию CUDA C

сделать  К:(США) от Джона Ченга и др.;
решительный  цена:99
из Версия общество:Машиностроительная промышленность Пресса
Дата публикации:01 июня 2017 г.
страница  число:412
установить  рамка:Мягкая обложка
ISBN:9787111565475
Каталог
Переводчик
Рекомендация
предисловие
Об авторе
Введение в школу технического обзора
Предисловие
Благодарности
Глава 1. Гетерогенные параллельные вычисления на основе CUDA 1
1.1 Параллельные вычисления 1
1.1.1 Последовательное программирование и параллельное программирование 2
1.1.2 Параллелизм 3
1.1.3 Архитектура компьютера 4
1.2 Гетерогенные вычисления 6
1.2.1 Гетерогенная архитектура 7
1.2.2 Пример 9 гетерогенных вычислений
1.2.3CUDA: гетерогенная вычислительная платформа 10
1.3 Использование графического процессора для вывода HelloWorld12
1.4 Сложно ли программировать с помощью CUDAC15
1.5 Резюме 16
1.6 Упражнение 16
Глава 2 Модель программирования CUDA 18
2.1 Обзор модели программирования CUDA 18
2.1.1 Структура программирования CUDA 19
2.1.2 Управление памятью 20
2.1.3 Управление потоками 24
2.1.4 Запуск функции ядра CUDA 29
2.1.5 Написание функции ядра 30
2.1.6 Проверка работы ядра 31
2.1.7 Обработка ошибки 32
2.1.8 Компиляция и выполнение 32
2.2 Синхронизация функции ядра 35
2.2.1 Тайминг 35 с таймером ЦП
2.2.2 Синхронизация с помощью инструмента nvprof 39
2.3 Организация параллельных потоков 40
2.3.1 Построение матричных индексов с использованием блоков и потоков 40
2.3.2 Суммирование матриц с использованием 2D-сеток и 2D-блоков 44
2.3.3 Суммирование матриц с использованием одномерных сеток и одномерных блоков 47
2.3.4 Суммирование матриц с использованием 2D-сеток и 1D-блоков 48
2.4 Управление устройствами 50
2.4.1 Запрос информации о графическом процессоре с помощью API среды выполнения 50
2.4.2 Определите лучший графический процессор53
2.4.3 Использование NVIDIA—smi запрашивает информацию о графическом процессоре 53
2.4.4 Настройка устройства 54 во время выполнения
2.5 Резюме 54
2.6 Упражнение 55
Глава 3 Модель выполнения CUDA 56
3.1 Обзор модели выполнения CUDA 56
3.1.1 Обзор архитектуры графического процессора 57
3.1.2 Ферми-архитектура 59
3.1.3 Архитектура Кеплера 61
3.1.4 Оптимизация драйвера конфигурационного файла 65
3.2 Понимание природы выполнения деформации потока 67
3.2.1 Перекосы ниток и блокировки ниток 67
3.2.2 Дифференциация варпов 69
3.2.3 Распределение ресурсов 74
3.2.4 Задержка сокрытия 76
3.2.5 Заполняемость 78
3.2.6 Синхронизация 81
3.2.7 Масштабируемость 82
3.3 Производительность параллелизма 83
3.3.1 Использование nvprof для обнаружения активных перекосов нитей 84
3.3.2 Использование nvprof для обнаружения операций с памятью 85
3.3.3 Увеличение параллелизма 86
3.4. Избегайте дифференциации ветвей 88
3.4.1 Задача параллельной редукции 88
3.4.2 Дифференциация при параллельном сокращении 89
3.4.3 Улучшение дифференциации параллельной редукции 93
3.4.4 Редукция шахматных пар 95
3.5 Разворачивание петель 97
3.5.1 Расширенное сокращение 97
3.5.2 Уменьшение раскатанных нитей 99
3.5.3 Полностью расширенное сокращение 101
3.5.4 Сокращение шаблонных функций 102
3.6 Динамический параллелизм 104
3.6.1 Вложенное выполнение 105
3.6.2 Вложение HelloWorld106 в графический процессор
3.6.3 Вложенная редукция 109
3.7 Резюме 113
3.8 Упражнение 113
Глава 4 Глобальная память 115
4.1 Обзор модели памяти CUDA 115
4.1.1 Преимущества иерархии памяти 116
4.1.2 Модель памяти CUDA 117
4.2 Управление памятью 124
4.2.1 Распределение и освобождение памяти 124
4.2.2 Перенос памяти 125
4.2.3 Фиксированная память 127
4.2.4 Память с нулевым копированием 128
4.2.5 Единая виртуальная адресация 133
4.2.6 Унифицированная адресация памяти 134
4.3 Шаблоны доступа к памяти 135
4.3.1 Выравнивание и объединенный доступ 135
4.3.2 Чтение глобальной памяти 137
4.3.3 Запись в глобальную память 145
4.3.4 Структура массива и структура массива 147
4.3.5 Настройка производительности 151
4.4 Достижимая полоса пропускания функции ядра 154
4.4.1 Пропускная способность памяти 154
4.4.2 Задача транспонирования матрицы 155
4.5 Сложение матриц с использованием единой памяти 167
4.6 Резюме 171
4.7 Упражнение 172
Глава 5. Общая память и постоянная память 174
5.1 Обзор общей памяти CUDA 174
5.1.1 Общая память 175
5.1.2 Распределение общей памяти 176
5.1.3 Общие банки памяти и режимы доступа 176
5.1.4 Настройка объема общей памяти 181
5.1.5 Синхронизация 183
5.2 Расположение данных в общей памяти 185
5.2.1 Квадратная общая память 185
5.2.2 Прямоугольная общая память 193
5.3. Уменьшите доступ к глобальной памяти 199
5.3.1 Параллельное сокращение с использованием общей памяти 199
5.3.2 Параллельное сокращение с использованием расширения 202
5.3.3 Параллельное сокращение с использованием динамической общей памяти 204
5.3.4 Эффективная полоса пропускания 205
5.4 Объединенный доступ к глобальной памяти 205
5.4.1 Базовое транспонированное ядро 205
5.4.2 Транспонирование матрицы с использованием общей памяти 207
5.4.3 Использование транспонирования матрицы, заполняющей разделяемую память 210
5.4.4 Использование транспонирования расширенной матрицы 211
5.4.5 Увеличение параллелизма 214
5.5 Постоянная память 215
5.5.1 Реализация одномерных шаблонов с использованием постоянной памяти 215
5.5.2 Сравнение с кэшем только для чтения 217
5.6 Инструкции по перетасовке варпа 219
5.6.1 Различные формы инструкций тасования варпов 220
5.6.2 Общие данные в деформации потока 222
5.6.3 Параллельная редукция с использованием инструкций Warp Shuffle 226
5.7 Резюме 227
5.8 Упражнение 228
Глава 6. Потоки и параллелизм 230
6.1 Обзор потоков и событий 231
6.1.1 Потоки CUDA 231
6.1.2 Планирование потоков 234
6.1.3 Приоритет потока 235
6.1.4События CUDA 235
6.1.5 Синхронизация потока 237
6.2 Параллельное выполнение ядра 240
6.2.1 Параллельные ядра в ненулевых потоках 240
6.2.2 Ложные зависимости от FermiGPU 242
6.2.3 Планирование операций с использованием OpenMP 244
6.2.4 Использование переменных среды для настройки поведения трафика 245
6.2.5 Параллельность ресурсов графического процессора 246
6.2.6 Поведение блокировки потоков по умолчанию 247
6.2.7 Создание межпотоковых зависимостей 248
6.3 Перекрытие выполнения ядра и передачи данных 249
6.3.1 Перекрытие с использованием планирования в глубину 249
6.3.2 Перекрытие с использованием планирования в ширину 252
6.4 Перекрытие выполнения графического процессора и центрального процессора 254
6.5 Обратный вызов потока 255
6.6 Резюме 256
6.7 Упражнения 257
Глава 7. Настройка примитивов уровня инструкций 258
7.1 Обзор инструкций CUDA 259
7.1.1 Инструкции с плавающей запятой 259
7.1.2 Внутренние функции и стандартные функции 261
7.1.3 Инструкции по атомарным операциям 262
7.2 Инструкции по оптимизации программы 264
7.2.1 Сравнение одинарной и двойной точности 264
7.2.2 Сравнение стандартных функций и внутренних функций 266
7.2.3 Понимание атомарных инструкций 272
7.2.4 Комплексный пример 277
7.3 Резюме 279
7.4 Упражнение 280
Глава 8. Библиотека ускорения графического процессора и OpenACC281
8.1 Обзор библиотеки CUDA 282
8.1.1 Области, поддерживаемые библиотекой CUDA 283
8.1.2 Общий рабочий процесс библиотеки CUDA 283
8.2cuSPARSE библиотека 285
8.2.1 Формат хранения данных cuSPARSE
8.2.2 Использование cuSPARSE для преобразования формата
8.2.3Пример функции cuSPARSE
8.2.4 Важные темы разработки cuSPARSE
8.2.5cuSPARSE Резюме
Библиотека 8.3cuBLAS
8.3.1 Управление данными cuBLAS
8.3.2Пример функцииcuBLAS
8.3.3 Важные темы разработки cuBLAS
8.3.4 Сводная информация о CuBLAS
8.4cuFFT библиотека
8.4.1 Использование cuFFTAPI
8.4.2Пример функцииcuFFT
8.4.3Сводка CuFFT
Библиотека 8.5cuRAND
8.5.1 Выбор квазислучайных или псевдослучайных чисел
8.5.2 Обзор библиотеки cuRAND
8.5.3cuRAND Введение
8.5.4 Важные темы разработки cuRAND
8.6 Введение в библиотеки функций в CUDA6.0
8.6.1Drop—В библиотеке
8.6.2 Библиотека с несколькими графическими процессорами
8.7 Исследование производительности библиотеки функций CUDA
8.7.1 Сравнение cuSPARSE и MKL
8.7.2 Сравнение cuBLAS и MKLBLAS
8.7.3 Сравнение cuFFT, FFTW и MKL
8.7.4 Сводная информация о производительности библиотеки CUDA
8.8Использование OpenACC
8.8.1 Использование инструкций расчета OpenACC
8.8.2 Использование инструкций данных OpenACC
8.8.3 API среды выполнения OpenACC
8.8.4 Комбинация библиотек OpenACC и CUDA
8.8.5Сводка OpenACC
8.9 Резюме
8.10 Упражнения
Глава 9 Программирование на нескольких графических процессорах
9.1 От одного графического процессора к нескольким графическим процессорам
9.1.1 Выполнение на нескольких графических процессорах
9.1.2 Двухточечная связь
9.1.3 Синхронизация между несколькими графическими процессорами
9.2 Расчет разделения между несколькими графическими процессорами
9.2.1 Распределение памяти на нескольких устройствах
9.2.2 Распределение работы между потоками одного хоста
9.2.3 Компиляция и выполнение
9.3 Одноранговая связь на нескольких графических процессорах
9.3.1 Реализация двухточечного доступа
9.3.2 Одноранговое копирование памяти
9.3.3 Двухточечный доступ к памяти с унифицированной виртуальной адресацией
9.4 Конечная разница на нескольких графических процессорах
9.4.1 Шаблонный расчет двумерного волнового уравнения
9.4.2 Типичные шаблоны программ с несколькими графическими процессорами
9.4.3 Расчет двумерного шаблона на нескольких графических процессорах
9.4.4 Перекрытие вычислений и связи
9.4.5 Компиляция и выполнение
9.5 Масштабирование приложений по кластерам графических процессоров
9.5.1 Передача данных между процессорами
9.5.2 Использование традиционного MPI для передачи данных между графическими процессорами
9.5.3 Использование CUDA—awareMPI выполняет передачу данных между графическими процессорами
9.5.4 Использование CUDA—awareMPI выполняет внутриузловую передачу данных между графическими процессорами
9.5.5 Настройка размера блока сообщений
Выполнение передачи данных между графическими процессорами
9.6 Резюме
9.7 Упражнения
……
Глава 10 Меры предосторожности при реализации программы
Приложение Рекомендуемая литература
Содержание пунктирное

Введение в контент

В этой книге в основном рассказывается, как использовать графический процессор и программировать его с использованием языка CUDAC. Сначала он начинается с основных концепций и структуры CUDA и шаг за шагом знакомит читателей с внутренним миром CUDA. В нем представлены требования к программированию и внутренняя архитектура от поверхностного к глубокому, чтобы после того, как читатели составят общее впечатление о нем, они могли постепенно глубже понять его внутренние функции, а затем представлены некоторые специальные функции и меры предосторожности, связанные с графическим процессором.
Об авторе

(США) от Джона Ченга и др.;

Джон Ченг, доктор философии, научный сотрудник BGP International в Хьюстоне.Он разработал продукты для сейсмической визуализации с использованием графических процессоров и разработал высокопроизводительные приложения для параллельного производства на многих гетерогенных вычислительных платформах.
Макс·Макс Гроссман — эксперт в области вычислений на графических процессорах и в основном использует CUDA для решения таких задач, как медицинская визуализация, машинное обучение и геофизика.
Тайский·Тай МакКерчер — главный архитектор решений NVIDIA. Команда, которую он возглавляет, специализируется на межотраслевой архитектуре визуальных компьютерных систем.Обычно он отвечает за обеспечение взаимодействия между клиентами и командами разработчиков продукции во время оценки новых технологий.

Краткое содержание

Перед введением    Добро пожаловать в чудесный мир гетерогенного параллельного программирования с помощью CUDA C!Современные гетерогенные системы движутся в будущее, наполненное безграничными вычислительными возможностями.Гетерогенные вычисления постоянно применяются в новых областях вычислений.—Все: от науки до баз данных и машинного обучения. Будущее программирования — это мир гетерогенного параллельного программирования!Эта книга поможет вам быстро приступить к вычислениям на графическом процессоре (GPU) с помощью платформы CUDA, набора инструментов CUDA и языка CUDA C. Примеры и упражнения, приведенные в этой книге, также помогут вам быстро разобраться в профессиональных знаниях CUDA и помогут как можно быстрее выйти на профессиональный уровень!Для кого эта книга? Эта книга предназначена для всех, кто хочет воспользоваться преимуществами вычислительной мощности графического процессора для повышения эффективности приложений.Он охватывает самые передовые технологии в области программирования на CUDA C и обладает следующими выдающимися преимуществами: лаконичный стиль, подробное описание, большое количество качественных упражнений, широкий охват, содержание, ориентированное на потребности высокопроизводительных вычислений. Если вы опытный программист на языке C и хотите улучшить свои профессиональные навыки в области высокопроизводительных вычислений, изучая CUDA C, рекомендуется прочитать эту книгу...