Обучение с подкреплением и оптимальное управление



Вес товара: ~0.7 кг. Указан усредненный вес, который может отличаться от фактического. Не включен в цену, оплачивается при получении.
Описание товара


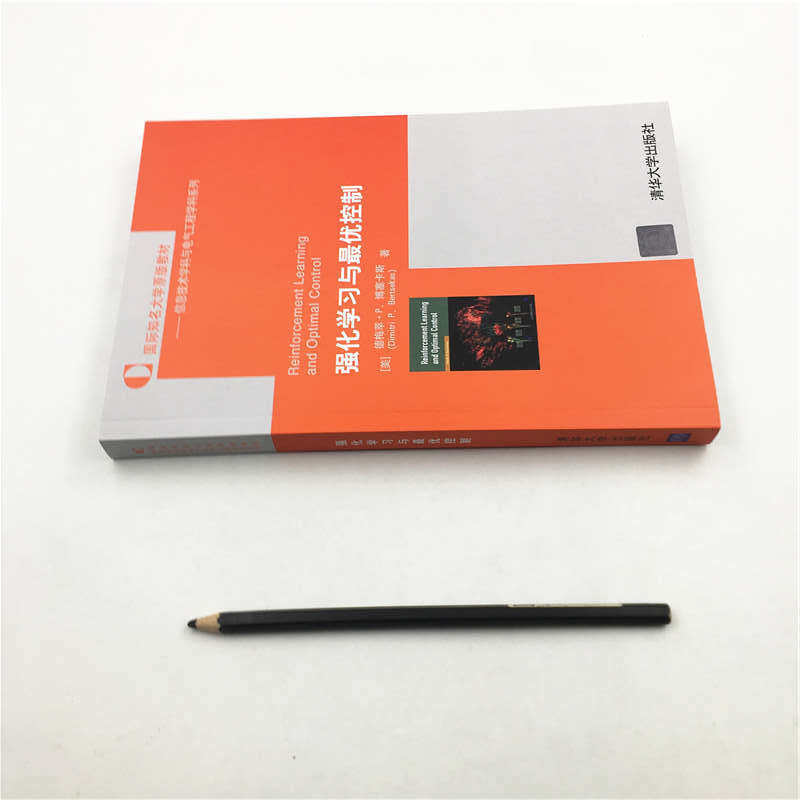
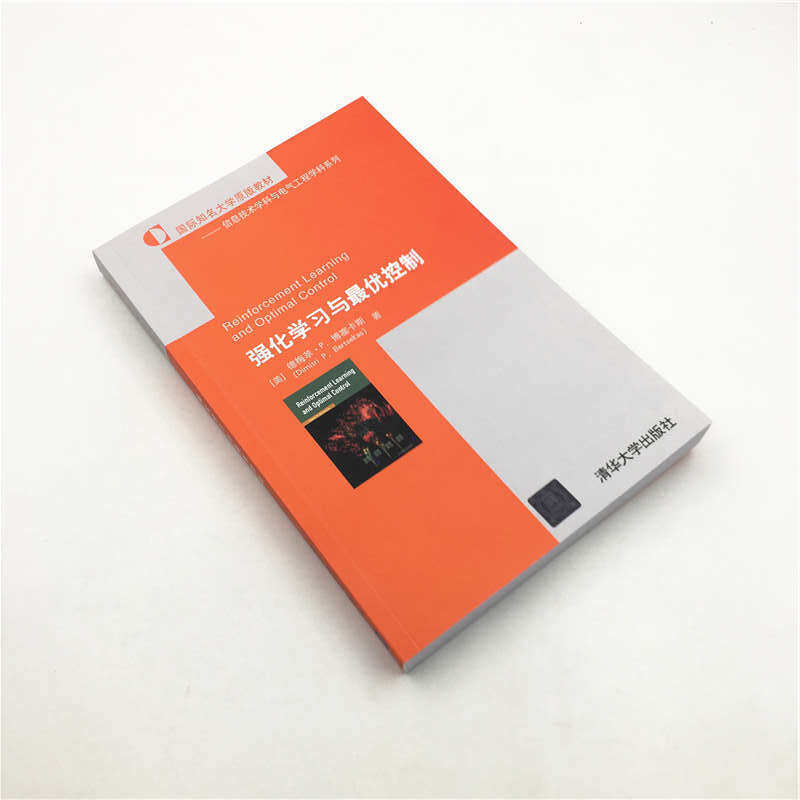
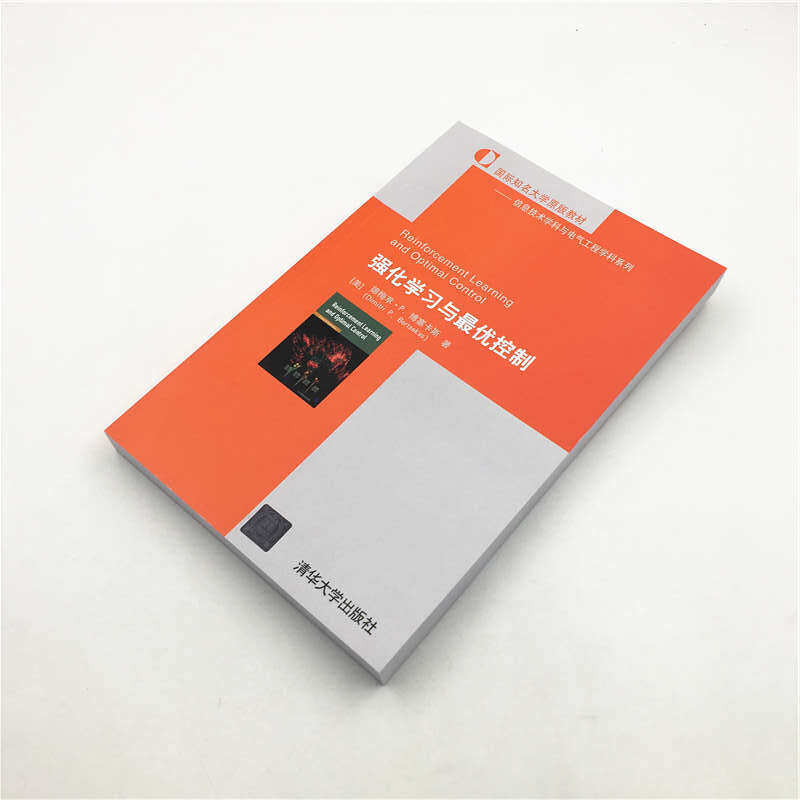

Димитрит П. Берцека, профессор пожизненного MIT, академик Национальной академии инженерной академии, профессора медицинского и сетевого исследовательского центра системного университета Университета Цинхуа, всемирно известных авторов в области электротехники и компьютерных наук, авторизованный «нелинейный план «,« Оптимизация сети »,« Выпуктная »оптимизация более чем дюжины лучших учебников и монографий.Цель этой книги состоит в том, чтобы рассмотреть большие и сложные проблемы с принятием решений в многоэтажном.Эта книга обсуждается, зависит от приблизительных решений для генерации субэксерельной стратегии с достаточной производительностью.Эти методы в совокупности называются расширенным обучением, или их также можно назвать приблизительным динамическим планированием и нейронным динамическим планированием.
Тема этой книги родилась во взаимодействии*мысли контроля и искусственного интеллекта.Одна из целей этой книги - изучить общую границу между этими двумя областями и установить мост, к которому можно получить доступ к любому местному происхождению.
1 Exact Dynamic Programming
1.1 DeterministicDynamicProgramming 2
1.1.1 DeterministicProblems 2
1.1.2 TheDynamicProgrammingAlgorithm 7
1.1.3 Approximation inValue Space 12
1.2 StochasticDynamicProgramming 14
1.3 Примеры, варианты и упрощения 18
1.3.1 Детерминированные проблемы кратчайшего пути 19
1.3.2 DiscreteDeterministicOptimization 21
1.3.3 Problemswith aTermination State 25
1.3.4 Forecasts 26
1.3.5 Проблемы с неконтролируемыми компонентами состояния 29
1.3.6 Информация о частичном состоянии и состояния убеждений 34
1.3.7 LinearQuadraticOptimalControl 38
1.3.8 Системы с неизвестными параметрами-адаптивные
Control 40
1.4 Обучение с подкреплением и оптимальный контроль — некоторые
Terminology 43
1.5 Notes and Sources 45
2 Approximation in Value Space
2.1 Аппроксимационные подходы в обучении с подкреплением 50
2.1.1 Общие вопросы аппроксимации в пространстве значений 54
2.1.2 Off-Line andOn-LineMethods 56
2.1.3 Упрощение прогноза на основе модели
Minimization 57
2.1.4 Автономная аппроксимация Q-фактора без модели 58
2.1.5 Аппроксимация в Политическом пространстве поверх
ApproximationinValue Space 61
2.1.6 Когда аппроксимация в пространстве значений эффективна? 62
2.2 Multistep Lookahead 64
??ii
viii Contents
2.2.1 Многошаговый прогноз и подвижный горизонт 65
2.2.2 Многошаговый прогноз и детерминированные задачи 67
2.3 Problem Approximation 69
2.3.1 Enforced Decomposition 69
2.3.2 Вероятностная аппроксимация — эквивалент достоверности
Control 76
2.4 Внедрение и принцип улучшения политики 83
2.4.1 Оперативное внедрение детерминированной дискретной системы
Optimization ......
Цель этой книги состоит в том, чтобы рассмотреть большие и сложные проблемы с принятием решений в многоэтажном.Эта книга обсуждается, зависит от приблизительных решений для генерации субэксерельной стратегии с достаточной производительностью.Эти методы в совокупности называются расширенным обучением, или их также можно назвать приблизительным динамическим планированием и нейронным динамическим планированием.Тема этой книги родилась во взаимодействии*мысли контроля и искусственного интеллекта.Одна из целей этой книги - изучить общую границу между этими двумя областями и установить мост, к которому можно получить доступ к любому местному происхождению.
......Димитрит П. Берцека, профессор пожизненного MIT в Соединенных Штатах, академик Национальной инженерной академии и приглашенный профессор в Комплексе Университета Цинхуа и исследования сетевой системы.Известные авторы в области электротехники и компьютерных наук, созданные более чем дюжиной лучших учебников и монографий, таких как «нелинейное планирование», «оптимизация сети» и «выпуклость оптимизации».