
8 (905) 200-03-37 Владивосток
с 09:00 до 19:00
CHN - 1.14 руб. Сайт - 21.13 руб.

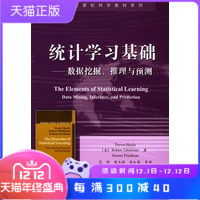
Гарантировать основной статистический обучение Фонд: добыча данных, рассуждения и прогнозирование Heisti и т. Д., Фан -Минг и другие издательства в области электронных промышленности.

Цена: 6 729руб.    (¥319.5)
Артикул: 626036140646

Вес товара: ~0.7 кг. Указан усредненный вес, который может отличаться от фактического. Не включен в цену, оплачивается при получении.

Этот товар на Таобао Описание товара
Продавец:海雷雾竹图书专营店
Адрес:Хэнань
Рейтинг:
Всего отзывов:0
Положительных:0
Добавить в корзину
Другие товары этого продавца
¥35740руб.
¥90.71 917руб.
¥29.5624руб.
¥33.3704руб.

         выше↑параметринформацияВ автоматическом генерировании Taobao есть ошибка, пожалуйста, обратитесь к деталям этой книги! Спасибо за понимание! O (n_n) o!

 4545.jpg

Объясните .jpg

   дорогие читатели, мы являемся официальным авторизованным магазином, если у вас есть проблемы после получения книгиПожалуйста, свяжитесь с обслуживанием клиентов MM, мы от всего сердца обратимся к нему!

Статистическое обучение Фонд: добыча данных, рассуждения и прогнозирование

сделать   автор:(США) Hasty et al., Перевод Fan Ming et al.
решительный  Цена:45
из&энсп; версия&энсп; агентство:Электронная промышленная пресса
Дата публикации:2004-1-1
страница  Количество:381

Каталог
●Чжан Юлу
Глава 2 Обзор руководящего обучения
2.1 Введение
2.2 Типы переменных и термины
2.3 Два простых метода прогнозирования: наименьшие квадраты и метод ближайшего соседа
2.4 Теория статистического суждения
2.5 Местные методы высокого размера пространства
2.6 Статистическая модель, приближение обучения и функции
2.7 Структурированная регрессионная модель
2.8 Класс метода ограниченной оценки
2.9 Выбор модели и компромисс с уклонной кости
Документация
упражнение
Глава 3 Линейные методы регрессии
3.1 Введение
3.2 Модель линейной регрессии и наименьшие квадраты
3.3 Из простого возврата в один долларов в множественную регрессию
3.4 Выбор подмножества и усадка коэффициента
3.5 Расчеты
Документация
упражнение
Глава 4 Линейные методы классификации
4.1 Введение
4.2 Линейная регрессия указанной матрицы
4.3 Линейный дискриминантный анализ
4.4 Логистическая регрессия
4.5 Разделение гиперплоскости
Документация
упражнение
Глава 5 Базовое расширение и регуляризация
5.1 Введение
5.2 сегментированные полиномы и сплайны
5.3 Фильтрация и извлечение функций
5.4 Гладкие сплайны
5.5 Автоматический выбор плавных параметров
5.6 Регрессия логотипов
5.7 Многомерная функция сплайна
5.8 регуляризация и регенерация ядерного пространства Гильберта
5.9 плавная волна
Документация
упражнение
Глава 6 Ядерные методы
6.1 Метод одномерного ядерного сглаживания
6.2 Выберите ширину сердечника
6.3 Локальная регрессия на IRP
6.4 Структурированная модель локальной регрессии на IRP
6.5 Местная вероятность и другие модели
6.6 Оценка и классификация ядерной плотности
6.7 Радиальная базисная функция и ядро
6.8 Смешанная модель для оценки и классификации плотности
6.9 Расчеты
Документация
упражнение
Глава 7 Оценка модели и выбор
7.1 Введение
7.2 Предвзятость, дисперсия и сложность модели
7.3 Разложение с уклонной к неподвижной
7.4 Оптимизм частоты ошибок обучения
7.5 Оценка ошибок прогнозирования в выборке
7.6 Количество действительных параметров
7.7 Байесовские методы и BIC
7.8 Небольшая длина описания
7.9 Vapnik-Chernovenkis Dimension
7.10 перекрестная проверка
7.11 Метод самообслуживания
Документация
упражнение
Глава 8 Присвоение модели и среднее значение
8.1 Введение
8.2 Метод самопомощи и метод максимальной вероятности
8.3 Байесовский метод
8.4 Связь между методом самопомощи и байесовским рассуждением
8.5 EM -алгоритм
8.6 MCMC, отобранный из задней части
8.7 Сумка
8.8 Среднее значение модели и стек
8.9 Поиск: воздействие
Документация
упражнение
Глава 9 Аддитивная модель, дерево и связанные с ними методы
9.1 Обобщенная модель сложения
9.2 ДЕРЕВЕРНЫЙ ПОДПИСА
9.3 PRIM—— Поиск удара
9.4 Марс: многомерная адаптивная регрессионная сплайн
9,5 Слоистого экспертного микса
9.6 Отсутствие данных
9.7 Расчеты
Документация
упражнение
Глава 0: Дерево продвижения и добавления
10.1 Метод улучшения
10.2 Улучшение модели с добавлением подгонки
10.3 Пошаговая аддитивная моделирование вперед
10.4 Функция экспоненциальных потерь и Adaboost
10.5 Зачем использовать экспоненциальные убытки
10.6 Функции потерь и надежность
10.7 Maning&4spot&Процесс
10.8 Пример: Данные спама
10.9 Поднимите дерево
10.10 Численная оптимизация
10.11 Поднимите деревья соответствующего размера
10.12 регуляризация
10.13 Интерпретируемость
10.14 Пример
Документация
упражнение
Глава 1 Нейронная сеть
11.1 Введение
11.2 Проекционная регрессия трассировки
11.3 Нейронная сеть
11.4 Установка нейронных сетей
11.5 Некоторые проблемы в обучении нейронных сетей
11.6 Пример: смоделированные данные
11.7 Пример: кодированные данные на молнии
11.8 Обсуждение
11.9 Расчеты
Документация
упражнение
Глава 2 поддержка векторной машины и дискриминации гибкости
12.1 Введение
12.2 Поддержка векторного классификатора
12.3
12.4 Продвижение линейного дискриминантного анализа
12.5 Анализ дискриминации гибкости
12.6 Анализ суждения наказания
12.7 Смешанный дискриминационный анализ
12.8 Расчеты
Документация
упражнение
Глава 3 Методы прототипа и соседства
13.1 Введение
13.2 Методы прототипа
13.3 Классификатор K-ближайшего соседа
13.4 Адаптивные методы ближайшего соседа
13.5 Расчеты
Документация
упражнение
Глава 4 Нет руководства обучения
14.1 Введение
14.2 Связанные правила
14.3 Анализ кластеризации
14.4 Самоорганизационное картирование
14.5 Основные компоненты, кривые и поверхности
14.6 Независимый анализ компонентов и отслеживание проекций зондирования
14.7 Многомерный стандарт
Документация
упражнение
Глоссарий
Рекомендации

Содержание пунктирное

Введение в контент

Быстрое развитие компьютерных и информационных технологий привело к массовым данным во многих областях, таких как медицина, биология, финансы и маркетинг. Понимание этих данных является проблемой, которая привела к разработке новых инструментов в области статистики и распространяется на новые области, такие как интеллектуальный анализ данных, машинное обучение и биоинформатика. Многие инструменты имеют общую основу, но часто выражаются в разных терминах. Эта книга представляет некоторые важные концепции в этих областях. Хотя применяются статистические методы, подчеркиваются концепции, а не математика. Многие примеры сопровождаются цветными картинками. Эта книга имеет широкий спектр контента, от обучения с гидом (прогнозы) до неоплачиваемого обучения. Темы, включая нейронные сети, машины поддержки векторных, деревья классификации и улучшение, всесторонне представлены в аналогичных книгах. n Эта книга может быть использована в качестве учебника для студентов и аспирантов в соответствующих специальностях в высших учебных заведениях. Для тех, кто связан со статистикой, теми, кто обеспокоен интеллектуальным анализом данных в научном сообществе и в отрасли, эта книга стоит прочитать. n t t

Похожего контента пока нетПохожего контента пока нетПохожего контента пока нетПохожего контента пока нет