


8 (905) 200-03-37 Владивосток
с 09:00 до 19:00
CHN - 1.14 руб. Сайт - 21.13 руб.

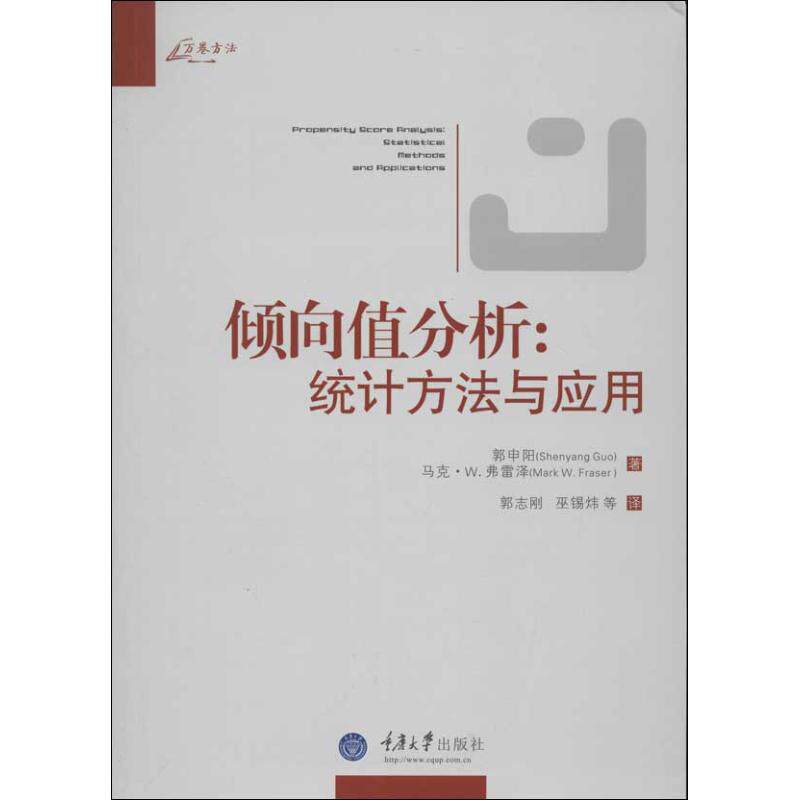
Анализ тенденций: статистические методы и приложения (США) Гу Шеньян, (США) Фрейзер работает Го Чиганг, Вуси Вей и другие переводчики Статистический аудит и вдохновляющий книжный магазин Синьхуа

Цена: 672руб.    (¥31.8)
Артикул: 556910586365

Вес товара: ~0.7 кг. Указан усредненный вес, который может отличаться от фактического. Не включен в цену, оплачивается при получении.

Этот товар на Таобао Описание товара
Продавец:四川画报社图书专营店
Адрес:Сычуань
Рейтинг:
Всего отзывов:0
Положительных:0
Добавить в корзину
Другие товары этого продавца
¥ 43.7 38.23808руб.
¥61.31 296руб.
¥30.8651руб.
¥ 22.41 21.39452руб.

Не титл -1.jpg

Анализ значения склонности: статистические методы и приложения

сделать   автор:(США) Го Шэньян, (США) Fraser Works Го Чжиган, У Сивэй и др. Переводчики
решительный  Цена:45
из&энсп; версия&энсп; агентство:Чунцинский университет издательство
Дата публикации:01 июня 2012 г.
страница  Количество:244
установить  Рамка:Мягкая обложка
ISBN:9787562466222
Каталог
●1. Введение
1.1 Наблюдательные исследования
1.2 История и развитие
1.3 Рандомизированные эксперименты
1.3.1 Машины Фишера
1.3.2 Типы рандомизированных экспериментов и статистических тестов
1.3.3 Критика социальных экспериментов
1.4 Зачем и когда необходим анализ склонностей?
1.5 Пакеты компьютерного программного обеспечения
1.6 Структура этой книги
2 Контрфактическая основа и предположения
2.1 Причинность, внутренняя обоснованность и угрозы
2.2 Контрфакты и контрфактическая структура Неймана-Рубина
2.3 Допущение о незначительном распределении вмешательств
2.4 稳定的单元干预值假定
2.5 Методы оценки эффектов вмешательства
2.5.1 Четыре модели
2.5.2 Другие методы балансировки
2.6 统计推断的基本逻辑
2.7 干预效应的类型
2.8 Хекман играет в роли главного героя.
2.9 Заключение
3 Традиционные методы балансировки данных
3.1 Почему необходима балансировка данных? Исследовательский пример
3.2 3 метода балансировки данных
3.2.1 Обычная регрессия наименьших квадратов
3.2.2 Сопоставление
3.2.3 Стратификация
3.3 数据模拟的设计
3.4 数据模拟的结果
3.5 Просвещение моделирования данных
3.6. Использование OLS в качестве источника питания.
3.7 Заключение
4 Выбор образца и связанные модели
4.1 Модель отбора выборки
4.1.1.
4.1.2 Почему важен выбор моделируемой выборки
4.1.3.
4.1.4 Модель Хекмана и ее двухшаговая оценка
4.2 Модель эффекта вмешательства
4.3 工具变量估计量
4.4 Статистические данные и методы обработки реестра
4.5 Примеры
4.5.1 Применение модели эффекта вмешательства в данных наблюдения
4.5.2 Оценка эффекта вмешательства программы, включающей кластерно-рандомизированный дизайн
4.5.3 Запустите модель эффекта вмешательства после многократного вменения недостающих данных
4.6 Заключение
5 дней в году
5.1 Обзор
5.2 维度问题以及倾向值的性质
5.3 Оценка значения склонности
5.3.1 Бинарная логистическая регрессия
5.3.2 Стратегии создания правильных моделей для прогнозирования значений склонности
5.3.3 Метод Хирано и Имбенса установки переменных-предикторов на основе заранее заданных критических значений t
5.3.4 一般化加速建模
5.4 Сопоставление
5.4.1 Жадное сопоставление
5.4.2 Лучший матч
5.4.3 Точная балансировка
5.5 Послематчевый анализ
5.5.1 Многомерный анализ после жадного сопоставления
5.5.2.
5.5.3 Расчет индекса ковариатного дисбаланса
5.5.4. Используйте упорядоченный ранговый критерий Ходжеса-Лемана для анализа результатов после наилучшего совпадения.
5.5.5 Корректировка регрессии на основе выборок, полученных путем оптимального парного сопоставления
5.5.6 Корректировка регрессии с использованием упорядоченного рейтинга Ходжеса-Лемана после наилучшего соответствия
5.6 Взвешивание значений склонности
5.7 Моделирование доз вмешательства
5.8 Обзор программ Stata и R
5.9 Примеры
5.9.1 Жадное сопоставление и последующий анализ степени риска
5.9.2 Лучший матч
5.9.3 Анализ после сопоставления с использованием упорядоченных рангов Ходжеса-Лемана
5.9.4 Анализ после сопоставления с использованием дифференциальной регрессии
5.9.5 Взвешивание значений склонности
5.9.6 Моделирование передозировки
5.9.7 Сравнение моделей и выводы исследования влияния бедности на успеваемость детей
5.9.8 Сравнение алгоритмов BOOST между RAND-GBM и Stata
5.10 Заключение
6 Соответствующий оценщик
6.1 Обзор
6.2 Методы сопоставления оценщиков
6.2.1 Простая оценка соответствия
6.2.2 Оценка соответствия с коррекцией смещения
6.2.3 Оценка дисперсии при условии однородности дисперсий
6.2.4 Оценка дисперсии с учетом гетероскедастичности
6.2.5 Свойства и коррекция больших выборок
6.3 Обзор программы Stata nnmatch
6.4 Примеры
6.4.1 Сопоставление с использованием коррекции систематической ошибки и устойчивой оценки дисперсии
6.4.2 Анализ подмножества мощности с использованием оценщиков соответствия
6.5 Заключение
7 Анализ значения склонности с использованием непараметрической регрессии
7.1 Обзор
7.2 Метод анализа значения склонности с использованием непараметрической регрессии
7.2.1 Средство оценки соответствия на основе ядра
7.2.2 Обзор основных понятий локальной линейной регрессии (lowess)
7.2.3 Асимптотические и конечно-выборочные свойства ядра и локальной линейной регрессии
7.3 Обзор программ Stata psmatch2 и bootstrap
7.4 Пример
7.4.1 Анализ различий в различиях
7.4.2 Применение сопоставления на основе ядра для данных за один момент времени
7.5 Заключение
8 Систематическая ошибка отбора и анализ чувствительности
8.1 Предвзятость отбора: обзор
8.1.1 Источники систематической ошибки отбора
8.1.2 Явная и скрытая предвзятость
8.1.3 Последствия систематической ошибки отбора
8.1.4 Стратегии исправления систематической ошибки отбора
8.2 Исследование Монте-Карло, сравнивающее модифицированные модели
8.2.1 План исследований Монте-Карло
8.2.2 Результаты исследований Монте-Карло
8.2.3 Вдохновение
8.3 Анализ чувствительности Розенбаума
8.3.1 Основная идея
8.3.2 Пример знаково-рангового критерия Уилкоксона для анализа чувствительности исследований подобранных пар
8.4 Обзор границ программы Stata
8.5 Примеры
8.5.1 Анализ чувствительности эффектов воздействия свинца
8.5.2 Анализ чувствительности при проведении исследований с парным сопоставлением
8.6 Заключение
9 Заключительные замечания
9.1 Распространенные ошибки в наблюдательных исследованиях: контрольный список для критического анализа
9.2 Аппроксимация экспериментов с использованием методов определения склонности
9.2.1 Критика метода значения склонности
9.2.2 Критика анализа чувствительности (T)
9.2.3 Групповые рандомизированные эксперименты
9.3 Другие достижения в моделировании причинно-следственной связи
9.4 Направление будущего развития
Рекомендации
Названный индекс
Индекс ключевых слов
Постмодель
Содержание пунктирное

Введение в контент

Эта книга знакомит с современными методами причинного анализа. В нем систематически представлены четыре передовых статистических метода причинно-следственного анализа в Соединенных Штатах.Как один из авторов этой книги, я очень рад, что вышла китайская версия «Анализ значений склонности: статистические методы и приложения».Я хотел бы воспользоваться этой возможностью, чтобы дать читателям краткое введение в происхождение и развитие метода причинного анализа, теоретическую основу, жанр и основные идеи анализа значения склонности, а также области применения метода значения склонности.
С самой слабой точки зрения мы можем видеть ветер, когда луна тусклая, дождь, когда основание влажное, и делать выводы от одного случая к другому, снаружи внутрь. Древние китайские мыслители уже давно ведут глубокие и острые дискуссии по анализу причин и следствий.Однако эмпирический анализ причинно-следственных связей с использованием строгой статистики и методов зародился в наше время.Причинный анализ социальных поведенческих явлений зародился в договорном гражданском обществе и имеет историю всего более ста лет.