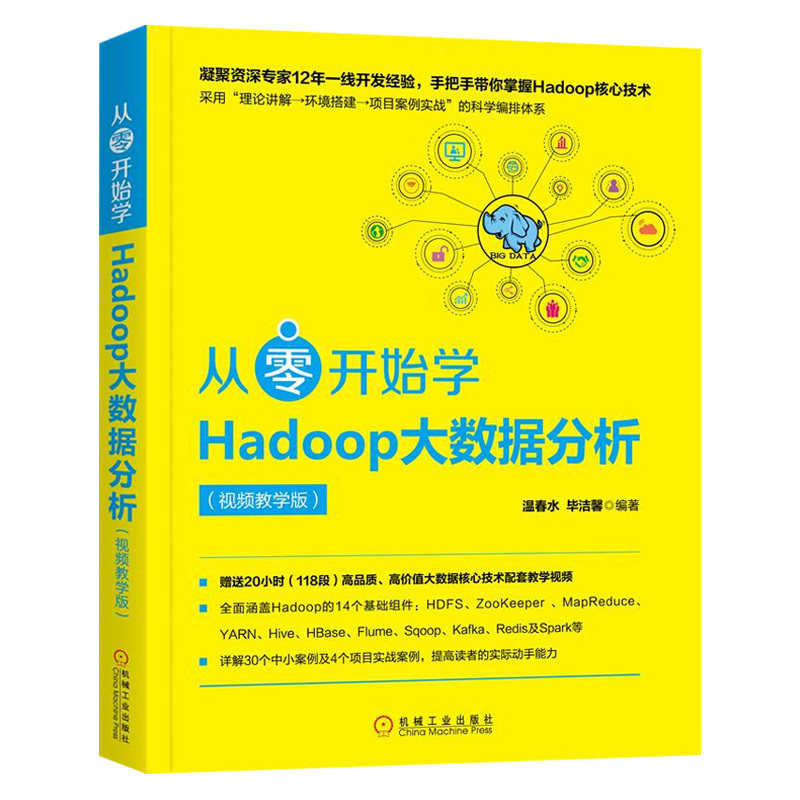
Новая книга 开 Изучение анализа больших данных Hadoop с нуля (издание видео обучения Wen Chunshui Hadoop Установка и конфигурация


Вес товара: ~0.7 кг. Указан усредненный вес, который может отличаться от фактического. Не включен в цену, оплачивается при получении.
Описание товара



| Изучите анализ больших данных Hadoop с нуля (версия для обучения видео) | ||
 | Ценообразование | 89.00 |
| Издатель | Машиностроительная промышленность Пресса | |
| Издание | 1-1 | |
| Опубликованная дата | ||
| формат | 16 | |
| автор | Wen Chunshui bi jiexin | |
| Украсить | Мягкая обложка | |
| Количество страниц | 346 | |
| Число слов | ||
| Кодирование ISBN | 9787111619314 | |

Эта книга предназначена для начинающих, которые готовы присоединиться к индустрии больших данных, и представила основные технологии и связанные с ним случаи процедур больших данных на простых и забавных языках.Содержание включает в себя базовую концепцию данных, установку и конфигурацию HADOOP, HDFS, HDFS HDFS Высокая доступность, Zookeeper, MapReduce, пряжа, SQOOP, KAFKA, REDIS, и каждая точка знаний оснащена случаями Чтобы понять процесс строительства и разработки корпоративных случаев от построения среды больших данных до основной технологии больших данных, чтобы легко ввести поле больших данных.Эта книга сильно практична, которая очень подходит для чтения читателей больших данных Hadoop, а также подходит для соответствующих колледжей в качестве учебников для анализа больших данных и добычи.

Предисловие
Первая часть 
Глава Один  Сначала знаю Hadoop2
1.1  Предварительное исследование по большим данным 2
1.1.1  Технология больших данных 2
1.1.2  Технологическая структура больших данных 3
1.1.3  Особенности больших данных 3
1.1.4  Применение больших данных в различных отраслях 4
1.1.5  Режим расчета больших данных 4
1.1.6  Взаимосвязь между большими данными и облачными вычислениями и Интернетом вещей 4
1.2  Hadoop Введение 5
1.2.1  Статус приложения Hadoop 6
1.2.2  Hadoop введение и значение 6
1.3  Резюме 6
Глава 2  Установка и конфигурация Hadoop 7
2.1  Создание виртуальной машины 7
2.2  Установить систему Linux 10
2.3  Настройка сетевой информации 11
2.4  Clone Server 12
2.5  SSH без пароля вход 13
2.6  Установите и настройте JDK15
2.6.1  Загрузите установку пакет 15
2.6.2  Установите JDK16
2.6.3  Настройка переменной среды 16
2.7  Конфигурация переменной среды Hadoop 16
2.7.1  Пакет сжатия Hadoop Decompress 17
2.7.2  Настройте папки Hadoop's Bin и SBIN в переменные среды17
2.7.3  Modify /etc/hadoop/hadoop-env.sh17
2.8  Hadoop Распределенная установка 17
2.8.1  Псевдо-распределенная установка 17
2.8.2  WAN Полная распределенная установка 19
2.9  Резюме 21
Глава 3  Hadoop распределенная файловая система 22
3.1  DFS Введение 22
3.1.1  Что такое DFS22
3.1.2  Структура DFS 22
3.2  HDFS Введение 23
3.2.1  Концепция и архитектура HDFS 23
3.2.2  HDFS Design 23
3.2.3  Плюсы и недостатки HDFS24
3.2.4  Принцип исполнения HDFS 24
3.2.5  Основная концепция HDFS25
3.2.6  HDFS Файл процесс 27
3.2.7  HDFS -процесс написания файлов 28
3.2.8  Блок Стратегия размещения копий 29
3.3  Общие команды для HDF в Hadoop 30
3.3.1  Операция в файлах 30
3.3.2  Управление и обновление 31
3.4  Приложение HDFS 31
3.4.1  Операция на основе оболочки 31
3.4.2  Операции на основе Java API33
3.4.3  Создайте папку 34
3.4.4  Рекурсивно отображать файл 34
3.4.5  Загрузка файла 35
3.4.6  Скачать файл 35
3.5  Резюме 36
Глава 4  HDFS Высокая доступность 37 на основе Hadoop 3
4.1  Hadoop 3.x разработка 37
4.1.1  Hadoop 3 новые функции 37
4.1.2  Hadoop 3 HDFS Set Architecture 38
4.2  Hadoop 3 HDFSWAN Полное распределенное строительство 39
4.2.1  Установите JDK40
4.2.2  Настройка переменной среды JDK 40
4.2.3  Настройка без пароля. Вход 40
4.2.4  Настройте отношения IP и имени хоста 41
4.2.5  SSH SSH без пароля настройки входа в систему 41
4.2.6  Настройте Hadoop 3.1.042
4.3  Что такое HDFS Высокая доступность 47
4.3.1  HDFS Высокая доступность Принцип 47
4.3.2  HDFS Высокая доступность реализация 48
4.4  Построить HDFS Высокая доступность 50
4.4.1  Настройте Zookeeper50
4.4.2  Настройка файла конфигурации Hadoop 52
4.4.3  Скопируйте файл конфигурации в другие узлы 54
4.4.4  Начните JN Узел 54
4.4.5  Формат 55
4.4.6  Скопировать метаданные в узле Node2 55
4.4.7  Формат ZKFC55
4.4.8  Набор стартапов 56
4.4.9  Просмотр Установка через статус браузера 56
4.4.10  Тест высокой доступности 57
4.5  Резюме 58
Глава 2 
Глава 5 ——ZooKeeper60
5.1  Zookeeper Core Concept 60
5.1.1  Механизм сеанса 60
5.1.2  Ассоциация между узлом данных, версией и наблюдателем61
5.1.3  ACL стратегия 61
5.2  Установка и операция Zookeeper 61
5.3  Общие команды на стороне сервера Zookeeper 63
5.4  Связанные операции клиентского соединения Zookeeper 64
5.4.1  Посмотреть Zookeeper Обычно используемые команды 64
5.4.2  Команда Connect и команда LS 65
5.4.3  Создать команду——
5.4.4  получить команду——
5.4.5  установить команду——
5.4.6  Удалить команду——
5.5  Access Zookeeper67 с использованием Java API
5.5.1  Подготовка среды и создание сессии Пример 68
5.5.2  Экземпляр создания узлов 69
5.5.3  Java API доступ к экземпляру Zookeeper 70
5.6  Резюме 73
Глава 6 ——MapReduce74
6.1  MapReduce Обзор 74
6.1.1  MapReduce Особенности 74
6.1.2  Сценарий приложения MapReduce 75
6.2  MapReduce Процесс выполнения 76
6.2.1  Статистика слов. Пример 76
6.2.2  MapReduce Процесс выполнения 77
6.2.3  MapReduce File Sclice Split77
6.2.4  Карта процесса и уменьшить процесс 78
6.2.5  Срайный процесс 78
6.3  MAPREDUCE ENSTEMS 79
6.3.1  WordCount локальный экземпляр тестирования 79
6.3.2  ETL локальный тест пример 84
6.4  Пример сортировки температуры 86
6.4.1  Класс инкапсуляции mykey.java87 для времени и температуры
6.4.2  Карта задачи mymapper.java88
6.4.3  Группировка данных MyGroup.java89
6.4.4  Класс сортировки температуры mysort.java89
6.4.5  Распределение данных mypartitioner.java90
6.4.6  Reducer Task MyReducer.java90
6.4.7  Основная функция runjob.java91
6.5  Резюме 94
Глава 7  Система управления ресурсами Hadoop——YARN95
7.1  Зачем использовать Yarn95
7.2  Яма базовая архитектура 96
7.2.1  ResourceManager Process 96
7.2.2  Applicationmaster и Nodemanager97
7.3  Рабочий процесс пряжи 97
7.4  Строительница пряжи 98
7.5  Резюме 100
Глава 8 ——Hive101
8.1  Теоретическая основа уля 101
8.1.1  Что такое hive101
8.1.2  Сходства и различия между улей и базой 102
8.1.3  Цель и применение дизайна уля 104
8.1.4  Операционная архитектура Hive 104
8.1.5  Процесс выполнения улей 105
8.1.6  Улей сервис 106
8.1.7  Metastore106
8.1.8  Встроенный режим 107
8.1.9  Локальный режим 108
8.1.10  Удаленный режим 109
8.2  Конфигурация и установка улей 109
8.2.1  Установите MySQL110
8.2.2  Настройте Hive112
8.3  Операция таблицы улей 113
8.3.1  Создать таблицу улей 114
8.3.2  Импорт данных 114
8.4  Таблица перегородка и ведро 115
8.4.1  Раздел 115 таблицы
8.4.2  Столовый ведро 117
8.5  Внутренние и внешние таблицы 118
8.5.1  Внутренняя таблица 119
8.5.2  Внешняя таблица 119
8.6  Встроенные функции и пользовательские функции 121
8.6.1  Пример встроенной функции 121